Acasă
» Cum să
»
Construiți un cluster SLES 15 HA acceptat cu Fencing First
Construiți un cluster SLES 15 HA acceptat cu Fencing First
Pentru SLES 15, înregistrați extensia SUSE Linux Enterprise High Availability, apoi utilizați crm cluster initși crm cluster joinpentru a boota nodurile. Înainte de a plasa serviciile în cluster, verificați rețeaua redundantă, fencing-ul nodurilor (STONITH) și cvorumul.
Această procedură respectă documentația SLE HA 15 SP7 actualizată în octombrie 2026. Confirmați pachetul service pack instalat și arhitectura procesorului; identificatorii de înregistrare și detaliile de asistență pot varia.
1. Pregătiți nodurile și rețeaua
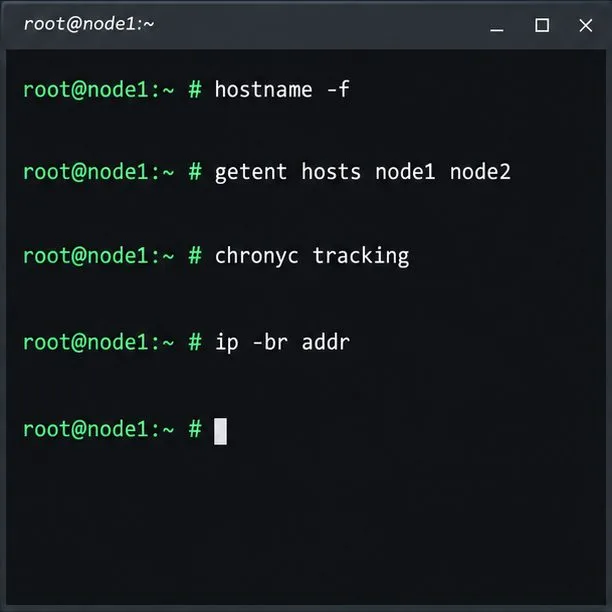
Verificați denumirea gazdei, rezoluția numelui, sincronizarea timpului și starea interfeței pe fiecare nod înainte de a forma clusterul.
Folosiți cel puțin două noduri pe aceeași arhitectură de procesor acceptată, adrese IP primare statice, nume unice rezolvabile pe fiecare nod și ceasuri sincronizate folosind o sursă de timp externă. SUSE necesită două căi de comunicație TCP/IP redundante per nod; numele interfețelor trebuie să se potrivească între noduri.
Rulați verificările pe ambele noduri și confirmați că interfețele și numele selectate sunt corecte înainte de bootare.
2. Înregistrați și instalați extensia High Availability
Pe fiecare nod, înregistrați extensia SLE HA și instalați modelul său de gestionare a clusterului.
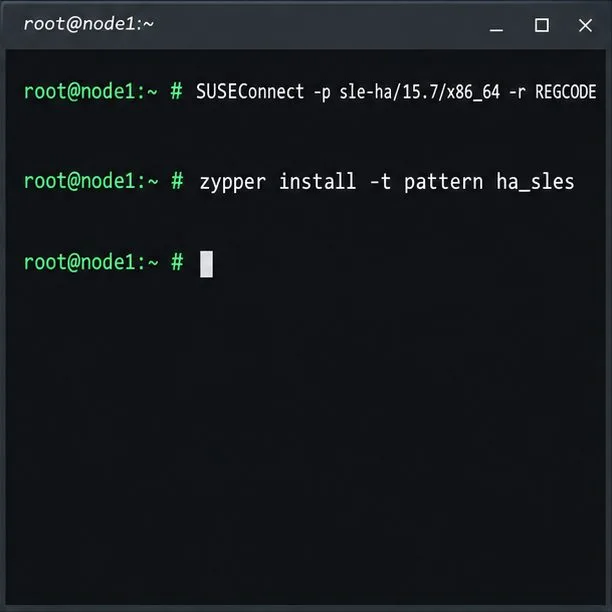
SLE HA este o extensie înregistrată separat; SLES singur nu include modelul de cluster. Pentru nodurile SLES 15 SP7 x86_64 înregistrate, activați extensia și instalați modelul pe fiecare nod:
Înlocuiți ADDITIONAL_REGCODEcu codul dvs. de abonament. Identificatorul de produs este pentru x86_64; utilizați identificatorul corespunzător SUSE pentru alte arhitecturi. Păstrați toate nodurile la același nivel SLES SP și SLE HA. Consultați ghidul de instalare SLE HA 15 SP7 de la SUSE .
3. Stabiliți limitele și cvorumul înainte de inițializare
Împărțirea este o cerință de suport; un cluster cu două noduri ar trebui, de asemenea, proiectat având în vedere comportamentul cvorumului.
Obligatoriu pentru clusterele acceptate: fencing-ul de noduri (STONITH), cu stonith-enabledși startup-fencinglăsat la valoarea true. Fencing-ul izolează un nod incert pentru a împiedica ambele părți ale unei partiții să ruleze același serviciu. Alegeți un dispozitiv de control al alimentării acceptat sau un SBD cu un watchdog testat pentru hardware-ul sau hypervisor-ul dvs.
Pentru două noduri: SUSE recomandă QDevice/QNetd pentru clustere de noduri pare. Adaugă un vot independent pentru cvorum, nu o fencing; configurați mai întâi serverul QNetd separat dacă includeți QDevice în timpul bootstrap-ului. Consultați ghidul QDevice și QNetd .
Concepție greșită despre stocare: stocarea partajată nu este obligatorie pentru fiecare cluster, dar datele aplicației au nevoie de propriul design partajat, replicat sau recuperabil. Pacemaker mută resurse; nu copiază datele aplicației.
4. Inițializați primul nod
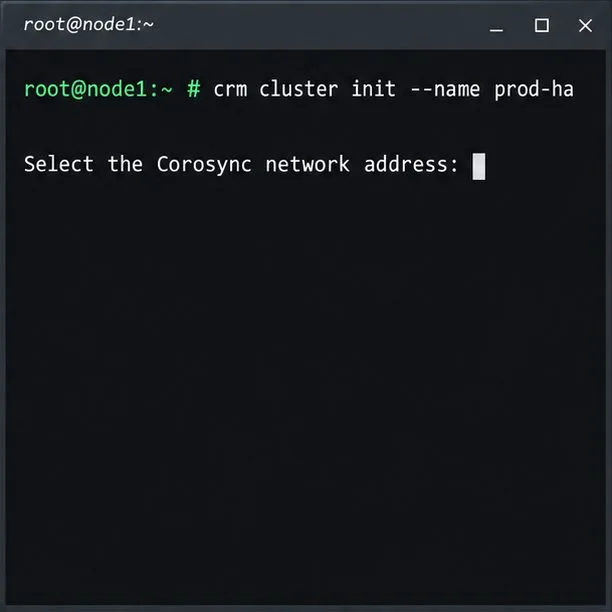
Scriptul bootstrap pornește pe nodul 1 și solicită adresa de rețea pe care ar trebui să o utilizeze Corosync.
Pe nodul 1, porniți bootstrapul CRM Shell ca root sau prin configurarea sudo-user aprobată:
crm cluster init --name prod-ha
Urmați instrucțiunile și selectați adresa Corosync dorită. Scriptul configurează Corosync, SSH, Csync2, porturile firewall ale clusterului și Hawk2; verifică sincronizarea temporală și oferă SBD opțional și o adresă IP de administrare Hawk2. Verificați /var/log/crmsh/crmsh.logsetările de bootstrap.
Configurați sistemul de supraveghere pe fiecare nod înainte de a selecta SBD. Dacă utilizați o fencing externă, configurați resursa STONITH acceptată înainte de sarcinile de lucru. Nu dezactivați niciodată STONITH pentru a ocoli un dispozitiv lipsă. Bootstrap creează un cluster de bază, nu o aplicație HA.
5. Alăturați-vă celui de-al doilea nod
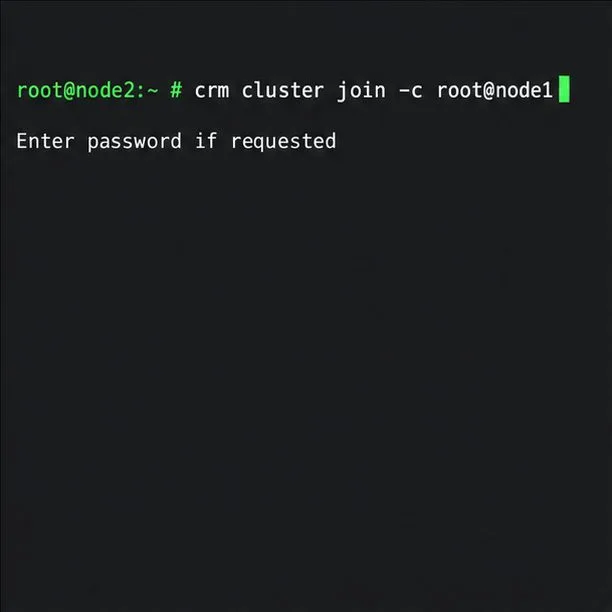
Rulați comanda join pe nodul 2; utilizați aceleași opțiuni de interfață de rețea făcute în timpul inițializării.
Instalați și înregistrați SLE HA pe nodul 2. Dacă utilizați SBD, pregătiți sistemul de supraveghere acolo înainte de a vă conecta. Apoi, ca root:
crm cluster join -c root@node1
Pentru o configurare cu ajutorul utilizatorului sudo, utilizați procedura SUSE USER@NODE1. Specificați aceleași două interfețe dacă au fost configurate la inițializare. Scriptul copiază setările Corosync, configurează SSH și Csync2 și aduce nodul 2 online. Repetați pentru mai multe noduri; nu combinați metodele de configurare bootstrap și YaST.
6. Confirmați calitatea de membru și securizați administrarea
Verificați starea calității de membru cu crm și înlocuiți parola bootstrap hacluster înainte de a utiliza Hawk2.
Dintr-un nod de cluster, verificați apartenența:
crm status
Verificați dacă ambele noduri sunt online și dacă există cvorum. Bootstrapul creează haclusterparola inițială linux; schimbați-o pe fiecare nod inițializat:
passwd hacluster
Hawk2 folosește HTTPS pe port 7630. Verificați un certificat autosemnat cu administratorul înainte de a-l considera de încredere. O adresă IP de administrare Hawk2 nu este adresa client a aplicației.
7. Adăugați resurse pentru serviciul pe care trebuie să îl protejați
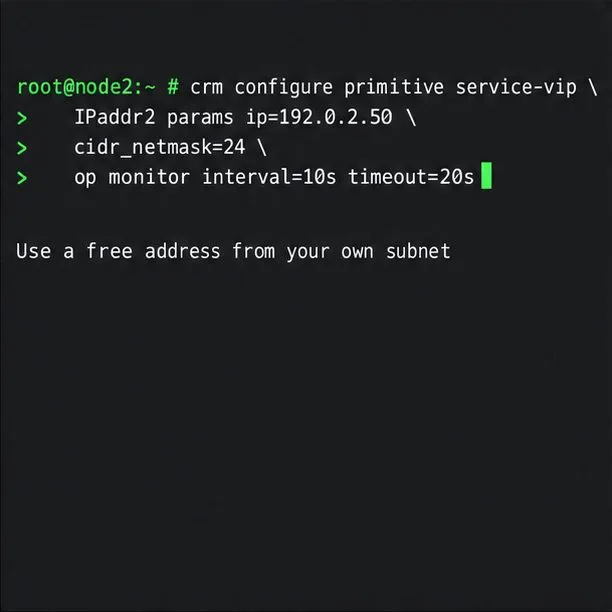
Exemplul definește doar o resursă IP flotantă; înlocuiți adresa sa de documentație cu o adresă neutilizată din subrețeaua dvs.
Pacemaker gestionează serviciile prin intermediul agenților de resurse. Instalați și configurați sarcina de lucru în mod corespunzător pe nodurile eligibile. Acest exemplu creează doar o primitivă IP flotantă:
192.0.2.50este rezervat pentru documentație. Înlocuiți o adresă liberă și un prefix corect din subrețeaua dvs. O primitivă IP nu pornește o aplicație și nu replică date. Adăugați agentul acceptat de aplicație plus comportamentul specific sarcinii de lucru privind ordinea, colocația și stocarea; urmați instrucțiunile de recuperare și izolare ale produsului respectiv.
8. Testați failover-ul înainte de a apela clusterul ca fiind pregătit
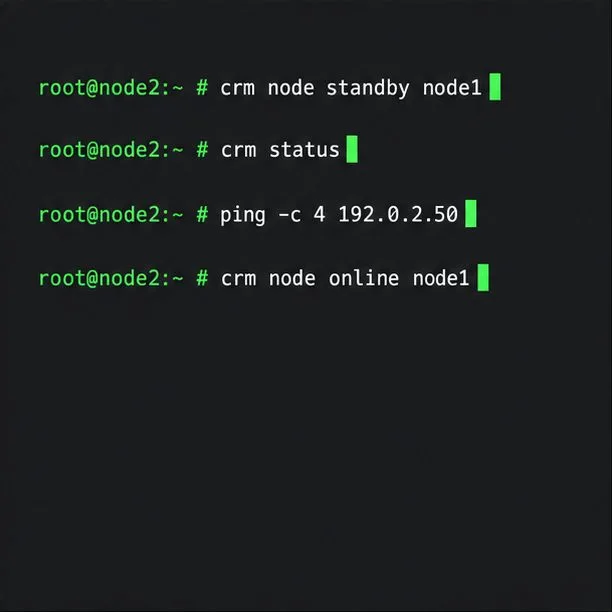
Un test de standby planificat verifică dacă resursa se mișcă, apoi repune nodul în funcțiune.
După configurarea resurselor reale și a fencing-ului, programați un test controlat de failover. Puneți nodul 1 în standby și verificați serviciul de la nodul 2:
Înlocuiți SERVICE_VIPcu adresa reală a clientului. Confirmați că aplicația răspunde, resursele se mișcă conform așteptărilor și nodul 1 se reunește. Ping verifică doar accesibilitatea rețelei. SUSE crm cluster crash_testperturbă intenționat componentele, așa că utilizați-l într-un mediu de testare planificat. Citiți ghidul de pornire rapidă și de fencing pentru instalarea SLE HA .
Verificați disponibilitatea serviciului
După testare, confirmați că ambele noduri au starea așteptată, că fencing-ul rămâne activat și că sarcina de lucru răspunde prin endpoint-ul clientului după ce nodul 1 revine online. O vizualizare verde a membrilor sau un ping reușit nu dovedesc singure recuperarea aplicației.