Montați o partajare SMB/CIFS în ownCloud fără o montare Linux
Conectați o partajare de rețea Windows sau Samba la ownCloud prin intermediul spațiului de stocare extern, verificați acreditările și depanați în siguranță folderele inaccesibile.
Puteți reduce riscul ca virusul OOM killer să oprească MySQL pe un VPS Debian 12 cu RAM redusă prin confirmarea cauzei, bugetarea memoriei pentru toate serviciile, limitarea concurenței bazei de date și furnizarea de swap acolo unde VPS-ul o permite. Un pool de buffere InnoDB mai mic nu este o soluție completă. Nici swap, nici o setare de protecție OOM nu garantează că o sarcină de lucru supradimensionată va continua să ruleze.
Acest ghid a fost realizat pe 9 octombrie 2026, folosind documentația Debian 12 „bookworm”, Linux 6.1 și Oracle MySQL 8.0/8.4. Setările de mai jos sunt puncte de plecare ilustrative, nu rezultate de referință sau o configurație universală. Faceți o copie de rezervă a bazei de date și a configurației înainte de modificări și programați repornirile bazei de date atunci când timpul de nefuncționare este acceptabil.
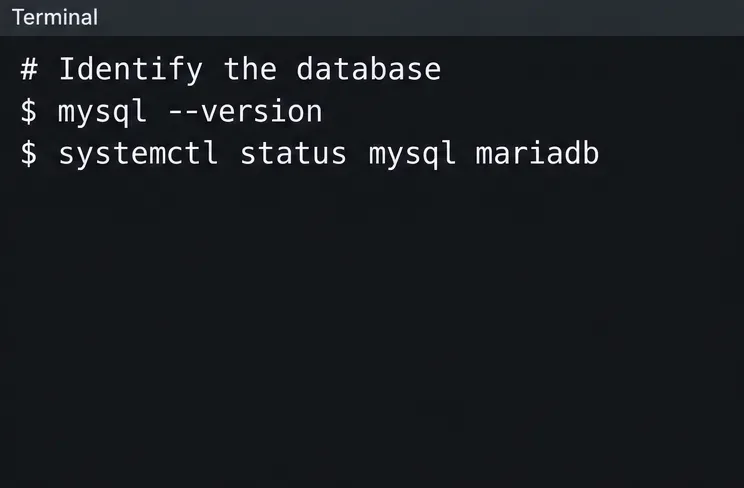
Verificat: Pachetul default-mysql-server din Debian 12 depinde de MariaDB. Un VPS descris ca rulând „MySQL” poate rula de fapt MariaDB, în timp ce altul poate avea Oracle MySQL dintr-un repozitoriu sau container separat.
mysql --version
systemctl status mysql mariadb
Prima comandă identifică clientul, nu în mod concludent serverul care rulează. Conectați-vă folosind contul de administrator al bazei de date și executați:
SELECT VERSION(), @@version_comment;Folosește metoda de autentificare existentă; instalările Debian MariaDB pot permite administrarea locală cu sudo mysql. Înregistrează versiunea serverului și numele real al serviciului. Comenzile de serviciu ulterioare utilizează mysql.service; pentru a înlocui comanda mariadb.serviceatunci când este cazul. Nu adaugă variabile exclusive Oracle în configurația MariaDB.
Neînțelegere frecventă: Fiecare repornire inexplicabilă a bazei de date este o întrerupere a serviciului OOM. Erorile de autentificare, epuizarea discului, configurația nevalidă, blocările și repornirile administratorului pot, de asemenea, întrerupe serviciul.
sudo journalctl -k -b
sudo journalctl -u mysql.service --since today
sudo journalctl -u systemd-oomd --since today
Verificați în jurul momentului incidentului mesajele kernel care identifică o condiție de memorie insuficientă și procesul închis, apoi corelați aceste mesaje cu jurnalul de service. De asemenea, verificați jurnalul de erori al bazei de date dacă pachetul îl scrie într-un fișier în loc de jurnal. Dacă incidentul s-a produs înainte de o repornire, verificați pornirea anterioară cu journalctl -k -b -1momentul în care sunt disponibile jurnalele păstrate. Lipsa jurnalelor istorice lasă cauza neconfirmată.
Un manager de spațiu utilizator poate, de asemenea, termina sarcini de lucru. Manualul systemd-oomd al Debian descrie intervenția bazată pe presiunea memoriei înainte de un eveniment OOM al kernelului. Verificați dacă este instalat și activ, mai degrabă decât să presupuneți că fiecare VPS Debian îl folosește.
Inspectați și limitele systemd:
systemctl show mysql.service \
  -p ControlGroup -p MemoryCurrent -p MemoryHigh \
  -p MemoryMax -p MemorySwapMax
Pe un sistem cgroup v2, utilizați calea ControlGroup raportată pentru a citi memory.events, memory.max, și memory.swap.maxsub /sys/fs/cgroup. Verificați și cgroup-urile părinte. Documentația Linux cgroup v2 explică aceste contoare și limite. Un cgroup poate rămâne fără memoria permisă chiar dacă gazda are capacitate. Un oom_killcontor înregistrează întreruperile, dar trebuie interpretat cu limite și jurnale pentru a stabili cauza.
free -h
ps -eo pid,comm,rss --sort=-rss
vmstat 1
Colectați observații în timpul traficului normal și al joburilor asociate cu eșecuri. În , concentrați-vă pe memoria disponibilă, nu doar pe coloana liberă. Manualul gratuitfree Debian descrie memoria disponibilă ca o estimare a ceea ce poate fi utilizat fără a face schimb de date. Valorile RSS din lista de procese sunt în KiB; adăugarea lor poate duce la numărarea dublă a memoriei partajate.
Verificat: MySQL alocă memorie dincolo de pool-ul de buffere al InnoDB, inclusiv alocări legate de conexiuni și interogări. Referința privind utilizarea memoriei MySQL documentează aceste componente. Tratați o formulă bazată pe buffere configurate ca o estimare de planificare, nu ca o limită superioară precisă.
Acțiune: Rezervați capacitate pentru kernel, workere web, monitorizare, copii de rezervă și lucrul tranzitoriu cu baza de date. Sfatul familiar de a dedica cea mai mare parte a memoriei RAM pentru InnoDB este nepotrivit fără ajustări pe un VPS partajat. Dacă workerele PHP sau un job de compilare consumă spațiul disponibil, ajustați sau mutați acel volum de lucru în loc să micșorați în mod repetat MySQL.
Dependent de context: Swap-ul poate absorbi o parte din presiunea temporară a memoriei anonime, dar swap-ul susținut poate face ca interogările să fie prea lente. Un VPS bazat pe containere poate restricționa swap-ul, iar un serviciu MemorySwapMaxpoate împiedica utilizarea acestuia chiar și atunci când gazda are swap.
swapon --show
free -h
df -h /
findmnt -no FSTYPE /
Dacă fișierul swap lipsește, furnizorul îl permite și aveți suficient spațiu pe disc, următoarele instrucțiuni creează un fișier swap de 1 GiB pe un sistem de fișiere local adecvat, cum ar fi ext4. Nu îl rulați dacă /swapfile există deja. Verificați mai întâi cerințele specifice sistemului de fișiere; Btrfs necesită o configurație adecvată pentru fișierele swap care nu permit copierea la scriere.
sudo dd if=/dev/zero of=/swapfile bs=1M count=1024 status=progress
sudo chmod 600 /swapfile
sudo mkswap /swapfile
sudo swapon /swapfile
swapon --show
Numai după ce activarea are succes, adăugați această intrare o dată la /etc/fstab:
/swapfile none swap sw 0 0Manualul Debian swapon documentează restricțiile privind fișierele swap. Dacă activarea este refuzată de mediul VPS, întrebați furnizorul despre fișierele swap acceptate sau măriți memoria planului; nu persistați o configurare eșuată.
Nu copiați o modificare „set swappiness la zero” ca protecție OOM. Documentația mașinii virtuale din kernel definește swappiness ca o preferință de cost de recuperare. Nu creează memorie și nu impune o limită de memorie pentru baza de date. Lăsați-o inițial neschimbată și măsurați comportamentul.
De exemplu, luați în considerare un VPS de 1 GiB cu o sarcină de lucru InnoDB mică și câțiva workeri de aplicații. Următoarele valori sunt un candidat pentru evaluare, nu o dovadă că această sarcină de lucru se potrivește:
[mysqld]
innodb_buffer_pool_size=128M
max_connections=20
tmp_table_size=16M
max_heap_table_size=16M
Plasați opțiunile serverului într-un fișier de configurare inclus efectiv în instalare. Un pachet Oracle MySQL poate include /etc/mysql/mysql.conf.d/; Debian MariaDB folosește în mod obișnuit /etc/mysql/mariadb.conf.d/. Verificați directivele de includere existente și păstrați o copie de rezervă. Documentația fișierelor de opțiuni MySQL explică grupurile de opțiuni ale serverului și gestionarea fișierelor.
Un pool de buffer de 128 MiB limitează memoria cache, nu memoria totală a bazei de date. O limită de 20 de conexiuni poate fi prea restrictivă dacă mai multe instanțe de aplicație mențin fiecare câte un pool. În schimb, 20 de interogări grele simultane pot suprasolicita VPS-ul. Mențineți totalurile pool-urilor de aplicații sub limita dorită pentru server, lăsând loc pentru acces administrativ, și observați conexiunile refuzate.
Variabilele comune de mai sus apar și în referința variabilelor de sistem MariaDB , dar comportamentul tabelelor temporare diferă în funcție de produs și versiune. Evitați creșterea bufferelor globale de sortare, joncțiune sau citire ca o soluție generică de performanță pe o mașină constrânsă.
Neînțelegere frecventă: Setarea tmp_table_size=16Mlimitei pentru toată memoria interogărilor la 16 MiB. Nu este așa. Pot coexista mai multe sesiuni, mai multe tabele temporare și alte alocări de execuție.
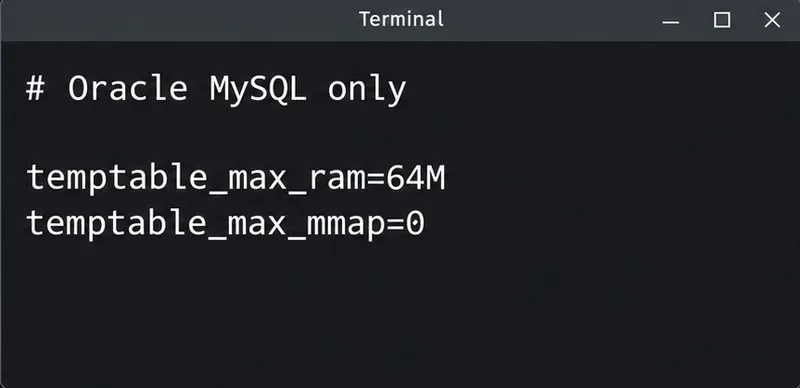
Pentru Oracle MySQL 8.4 , un punct de plecare suplimentar ilustrativ este:
temptable_max_ram=64M
temptable_max_mmap=0
Adăugați-le în grupul existent [mysqld]numai după confirmarea suportului pentru produs. Acestea guvernează pragul de RAM partajat al motorului TempTable și utilizarea fișierelor temporare mapate în memorie. Nu limitează întregul proces mysqld sau toate alocările locale ale firelor de execuție. Pragurile mai mici pot împinge mai multă muncă pe disc.
Documentația tabelelor temporare MySQL 8.4 explică aceste limite. MySQL 8.0 are un comportament dependent de versiune: temptable_max_mmapa apărut în versiunea 8.0.23 și tmp_table_sizea devenit o limită individuală pentru tabelele temporare în versiunea 8.0.28. Consultați referința MySQL 8.0 înainte de a aplica aceleași setări. Nu copiați aceste opțiuni specifice Oracle în MariaDB.
Acțiune: Limitați interogările de rapoarte care se suprapun, lucrătorii în fundal și joburile de backup sau import. Revizuiți planurile de interogare și indexurile atunci când o anumită operațiune declanșează presiune. Mutarea lucrărilor supradimensionate din zona de vârf de trafic poate fi de ajutor; dacă cererea concurentă normală depășește în continuare capacitatea, pasul următor adecvat este memoria RAM suplimentară sau separarea bazei de date.
Pentru versiunile Oracle MySQL care acceptă această opțiune, verificați configurația înainte de a reporni:
sudo mysqld --validate-configFolosește aceeași cale pentru fișierul cu valori implicite și argumentele de pornire relevante ca și serviciul dacă acesta nu utilizează descoperirea configurației implicite. Referința de validare MySQL menționează că validarea nu inițializează fiecare subsistem. Trecerea acesteia nu este un test al capacității sarcinii de lucru. Nu presupune că MariaDB acceptă această opțiune Oracle.
Reporniți serviciul propriu-zis în timpul ferestrei planificate, apoi inspectați pornirea și interogați valorile efective:
sudo systemctl restart mysql.service
systemctl status mysql.service
sudo journalctl -u mysql.service --since today
SHOW GLOBAL VARIABLES WHERE Variable_name IN
('innodb_buffer_pool_size','max_connections','tmp_table_size',
'max_heap_table_size','temptable_max_ram','temptable_max_mmap');
SHOW GLOBAL STATUS WHERE Variable_name IN
('Threads_connected','Threads_running','Max_used_connections');Variabilele neacceptate nu vor apărea în rezultate. Verificați setările dorite, în loc să presupuneți că noul fișier are prioritate. Dacă pornirea eșuează din cauza modificării dvs., restaurați configurația salvată sau eliminați doar noua suprascriere, apoi reporniți. Păstrați detaliile erorii pentru diagnosticare.
free -h
vmstat 1
cat /proc/pressure/memory
Comparați același trafic și joburi programate înainte și după modificări. Urmăriți evenimente OOM noi, repornirile bazei de date, memoria disponibilă, refuzurile conexiunilor, activitatea de swap și latența interogărilor. În vmstat, swap-in/swap-out susținut merită investigat. Manualul Debian vmstat explică faptul că primul raport mediază activitatea de la pornire; utilizați rapoartele ulterioare pentru ratele actuale.
Referința PSI a kernelului descrie măsurătorile de blocare a presiunii. Creșterea timpului de blocare a memoriei poate dezvălui probleme chiar înainte de o altă închidere. Un sistem inactiv care supraviețuiește zece minute nu stabilește că următoarea copie de rezervă sau rafală de trafic este sigură.
| Revendicare | Ce să faci în schimb |
|---|---|
| Protejați mysqld de OOM și lipsa dispare. | Reduceți cererea sau adăugați capacitate; modificarea selecției victimelor poate muta eșecul către un alt proces. |
| Setați un MemoryMax mic pentru a se potrivi MySQL. | Inspectați limitele existente și ajustați mai întâi volumul de lucru; o limită rigidă poate declanșa un OOM în cadrul serviciului. |
| Repornește automat și baza de date este stabilă. | Folosește comportamentul de repornire pentru recuperare, măsurând în același timp dacă presiunea inițială se menține. |
| Dezactivați setările de durabilitate pentru a economisi RAM. | Păstrați cerințele de recuperare și durabilitate separate de reglarea memoriei. |
Manualul de control al resurselor systemd din Debian explică faptul că MemoryMaxse poate invoca gestionarea OOM în cadrul unei unități. Nu eliminați orbește limitele furnizorului sau containerului. Aplicația are nevoie de un buget de memorie care să se încadreze în aceste limite sau limitele necesită o modificare autorizată a capacității.
Nu există o dimensiune minimă verificată a VPS-ului care să garanteze că acest anumit volum de lucru va rula. Dacă debitul util necesită schimbarea continuă a datelor, dacă joburile programate declanșează în continuare întreruperi ale datelor sau dacă memoria cache mai mică face ca latența să fie inacceptabilă, nu mai tratați configurația ca un substitut pentru capacitate. Actualizați memoria RAM, reduceți concurența aplicațiilor sau mutați baza de date într-un serviciu separat.
Conectați o partajare de rețea Windows sau Samba la ownCloud prin intermediul spațiului de stocare extern, verificați acreditările și depanați în siguranță folderele inaccesibile.
Eliminați fiecare versiune de fișier ownCloud Server Classic stocată pentru un cont sau pentru toți utilizatorii și faceți diferența între o eliminare completă și o expirare bazată pe retenție.
Urmăriți un refuz al conexiunii mobile ownCloud verificând adresa URL a serverului, rețeaua telefonică, endpoint-ul HTTPS și jurnalele serverului în ordinea corectă.
Înlocuiți rularea joburilor la cerere cu un cronometru systemd care rulează comanda occ system:cron acceptată de ownCloud la fiecare 15 minute.
Urmăriți cererea WebDAV prin Apache, Nginx sau un proxy invers, apoi confirmați că sincronizarea ownCloud funcționează cu un test PROPFIND autentificat.
Remediați avertismentul privind lipsa adresei de ieșire din Nextcloud prin setarea adresei URL canonice și verificarea DNS, HTTPS și a rutării reverse-proxy de pe server.
Configurați APCu și Redis printr-un socket Unix local pentru cache-ul Nextcloud și blocarea fișierelor, cu pași pentru versiunile actuale și mai vechi de Nextcloud.
Verificați modul cron al Nextcloud, reparați serviciul systemd și cronometrul și verificați dacă joburile de fundal rulează după pornire și la fiecare cinci minute.
Activează blocarea fiabilă a fișierelor Nextcloud, alege backend-ul Redis sau Valkey potrivit și verifică dacă avertismentul dispare fără a risca modificări simultane ale fișierelor.
Corectează rezultatele comune ale scanărilor Nextcloud cu actualizări actuale, HTTPS și HSTS, încredere precisă în reverse-proxy și verificări pe serverul public.