Acasă
» Cum să
»
Diagnosticarea unui server SUSE care se blochează la ecranul de închidere systemd
Diagnosticarea unui server SUSE care se blochează la ecranul de închidere systemd
Dacă serverul SUSE Linux Enterprise se blochează în timpul închiderii systemd, identificați unitatea cu o operațiune de oprire care rulează sau inspectați mesajele finale de la pornirea anterioară, apoi remediați unitatea respectivă sau dependența acesteia. O unitate este o resursă gestionată de systemd, cum ar fi un serviciu sau o montare; o operațiune de oprire este o solicitare a systemd de a opri o unitate. Nu reduceți un timeout global și nu forțați oprirea ca primă remediere, deoarece un serviciu sau un sistem de fișiere poate închide fișiere sau scrie date în continuare.
Această demonstrație urmează documentația SLES 15 SP7 verificată în octombrie 2026. Politica exactă de oprire depinde de furnizorul de servicii și de stocare, așadar, utilizați îndrumările acestora pentru orice modificări specifice unității.
1. Respectați oprirea în siguranță
Pasul 1: Înregistrați mesajul exact și așteptați dovezi utile
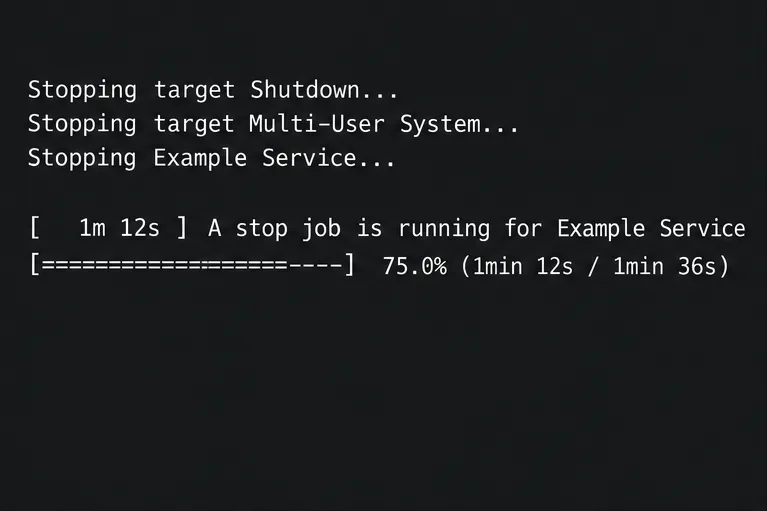
Dacă consola afișează mesajul „O operațiune de oprire rulează timp de…” cu o numărătoare inversă, notați serviciul sau montarea denumită și dacă temporizatorul se modifică. Aceasta înseamnă că systemd așteaptă operațiunea de oprire a unității respective, nu neapărat că sistemul de operare s-a blocat; bazele de date și stocarea la distanță pot necesita timp pentru a se închide corect.
Un exemplu de mesaj de consolă denumește unitatea pe care systemd o așteaptă; serviciul afișat și numărătoarea inversă sunt ilustrative.
Observați prin intermediul consolei de la distanță sau seriale sau al unui alt terminal disponibil. Evitați comenzile de resetare sau de alimentare în timp ce scrierile sunt în desfășurare. Dacă sistemul nu mai răspunde, înregistrați ultima linie vizibilă și continuați după ce pornește.
2. Găsiți unitatea care așteaptă
Pasul 2: Inspectați joburile systemd dacă mașina încă acceptă comenzi
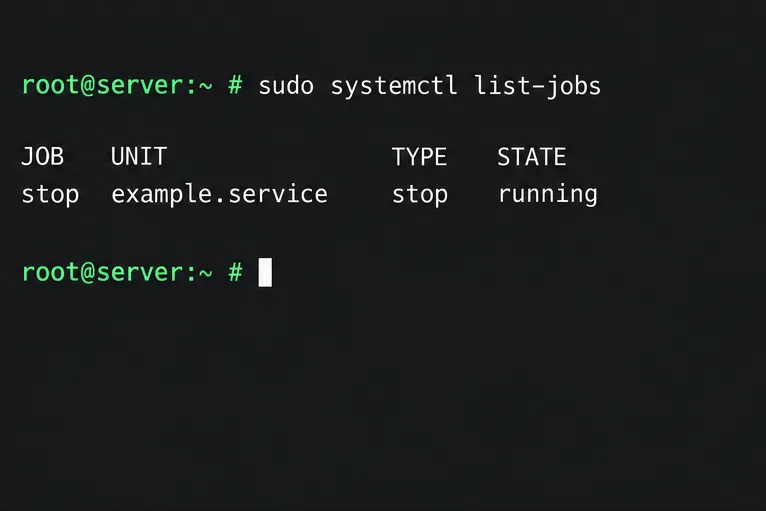
Dacă SSH sau un al doilea terminal funcționează în continuare, întrebați systemd ce joburi rulează sau așteaptă, apoi verificați unitatea numită pe ecran:
sudo systemctl list-jobs
sudo systemctl status SERVICE.service
Lista de joburi poate identifica un serviciu a cărui operațiune de oprire este încă în desfășurare; rândul afișat este un exemplu.
Înlocuiți SERVICEcu numele unității reale. O operațiune de oprire care rulează restrânge căutarea, dar nu explică de ce procesul nu s-a încheiat. Citiți starea și jurnalele sale înainte de a modifica configurația. Dacă systemd nu mai răspunde, nu anulați operațiunile orbește; inspectați jurnalul anterior după ce gazda se întoarce.
3. Folosește pornirea anterioară pentru a identifica cauza
Pasul 3: Citiți sfârșitul jurnalului pornirii anterioare
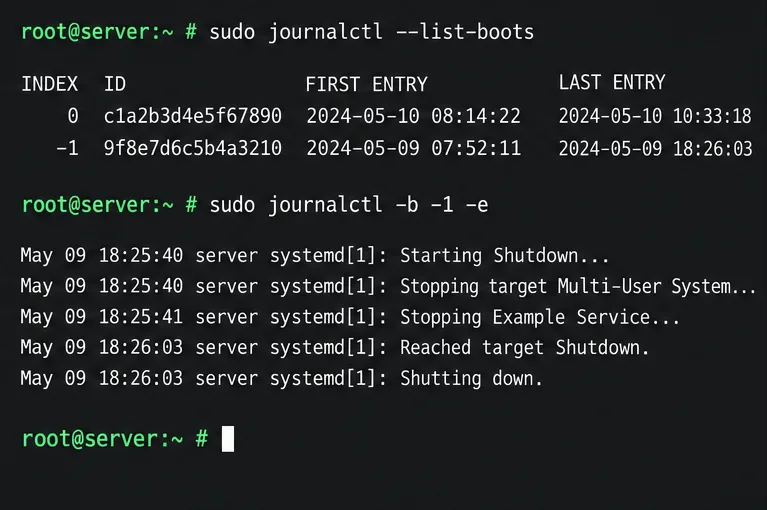
Jurnalul este jurnalul indexat al systemd cu mesajele kernelului, serviciului și sistemului. După următoarea pornire reușită, listați pornirile înregistrate și verificați sfârșitul celei anterioare:
Offset -1-ul selectează boot-ul precedent și -ese mută la cele mai recente intrări ale acestuia.
Căutați ultimul mesaj „Oprire”, o expirare, reîncercări sau un dispozitiv sau o montare denumită. Ultima linie este doar un indiciu: comanda de oprire poate lăsa o altă unitate în așteptare. Comparați timestamp-urile și mesajele din apropiere.
Pasul 4: Filtrarea jurnalelor pentru serviciul suspectat
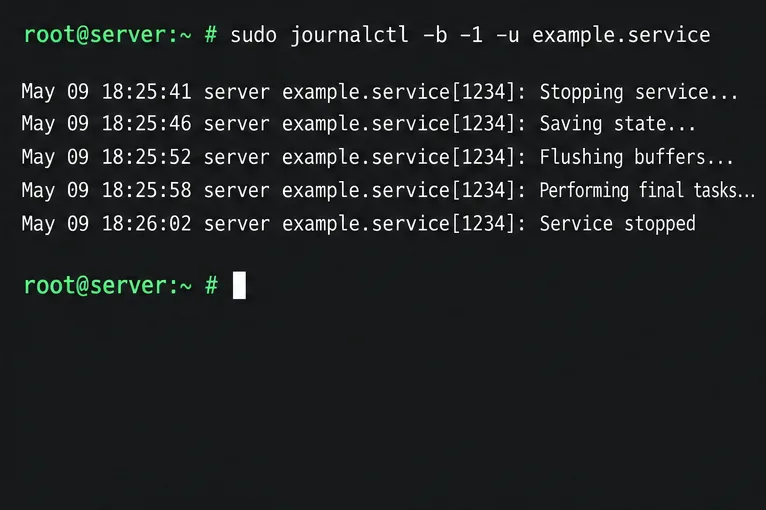
Când ecranul sau jurnalul denumește un serviciu, interogați doar intrările de pornire anterioară ale acelei unități. Verificați și configurația încărcată:
Filtrarea după unitate ajută la distingerea unei opriri lente a serviciului de mesajele fără legătură din altă parte a jurnalului.
Verificați dacă există o configurație personalizată ExecStop, un script care așteaptă la nesfârșit, un proces copil care persistă sau o eroare de aplicație în hook-ul său de închidere. Pentru unitățile furnizorului, comparați pachetul și configurația cu instrucțiunile acceptate înainte de editare.
Pasul 5: Verificați suporturile și depozitarea doar atunci când există dovezi care indică acest lucru
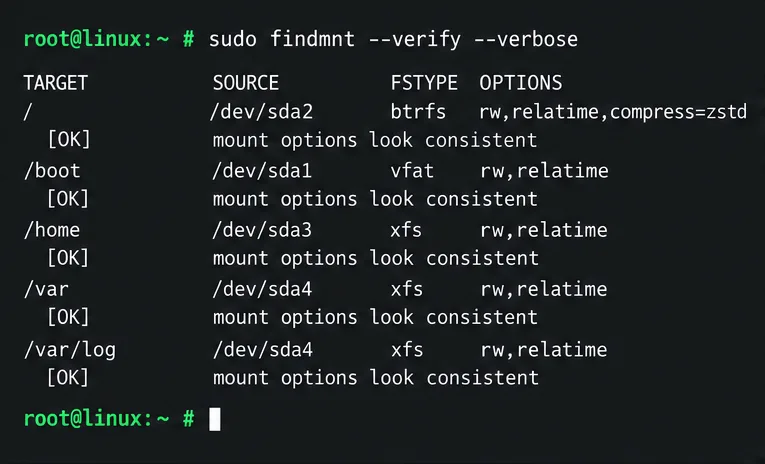
Dacă jurnalul denumește o montare, un dispozitiv sau un sistem de fișiere la distanță, verificați tabela de montare și intrarea corespunzătoare din /etc/fstab:
sudo findmnt --verify --verbose
Folosește verificarea montării atunci când jurnalele implică o montare; intrările afișate sunt ilustrative și trebuie verificate în raport cu gazda.
Verificați dacă o dependență NFS, CIFS, iSCSI sau altă dependență la distanță este accesibilă și așteptată în timpul închiderii. Eliminați o intrare de montare învechită numai după ce confirmați că este neutilizată. Nu forțați demontarea unui sistem de fișiere live doar pe baza unei reporniri lente.
4. Remediați cauza fără a o ascunde
Pasul 6: Reparați serviciul sau ajustați doar politica de oprire documentată a acestuia
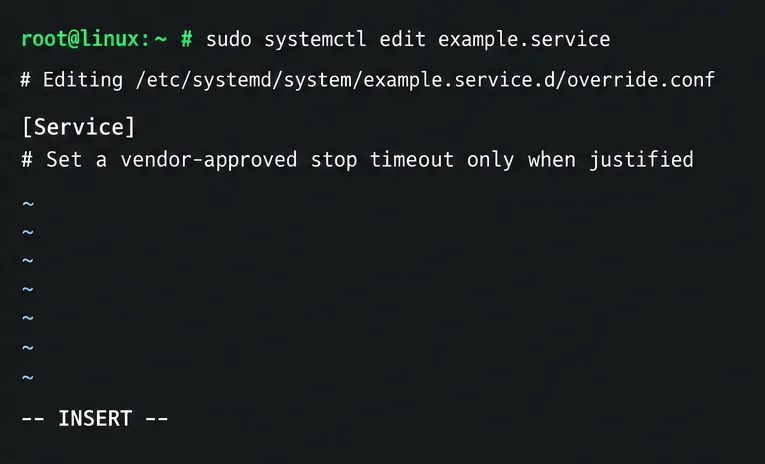
Pentru un serviciu care nu se închide, remediați mai întâi problema scriptului de închidere, a configurației aplicației sau a pachetului. O modificare per unitate de la sudo systemctl edit SERVICE.serviceeste stocată în /etc/systemd/system/fără a edita fișierul furnizorului. Documentele SUSE TimeoutSecpentru pornirea sau oprirea serviciului; utilizați o valoare aprobată de furnizor pentru această sarcină de lucru.
O unitate introdusă poate conține o suprascriere țintită; nota afișată este o îndrumare, nu o valoare de timeout.
După o editare documentată, reîncărcați definițiile unităților systemd cu sudo systemctl daemon-reloadși inspectați rezultatul cu sudo systemctl cat SERVICE.service. Un timeout mai lung poate permite finalizarea unei închideri legitime, dar poate prelungi și o repornire eșuată. Un timeout mai scurt poate termina un serviciu înainte de a goli starea acestuia. Nu modificați setările implicite globale pentru a ascunde defectul unei unități.
Pasul 7: Păstrați jurnalele pentru următorul incident
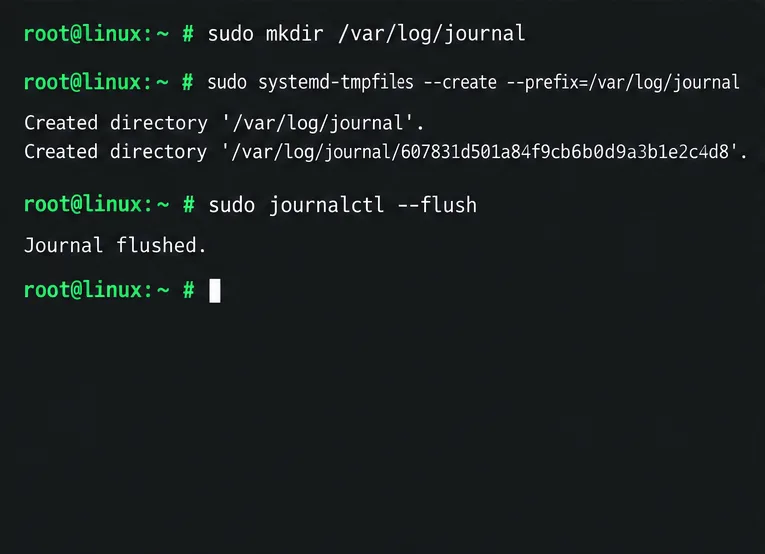
SLES stochează datele din jurnal în /run/log/journal/mod implicit, iar directorul volatil este șters la repornire. Dacă journalctl -b -1nu are intrări la pornirile anterioare, activați stocarea persistentă a jurnalului pentru diagnostice viitoare:
Aceste comenzi păstrează noile intrări în jurnal după reporniri; nu pot restaura jurnalele deja pierdute din memoria volatilă.
Jurnalele persistente utilizează spațiu sub /var; SUSE notează că jurnalul poate utiliza până la 10% din sistemul de fișiere respectiv în mod implicit. Verificați spațiul liber și retenția, în special pe /varvolume mici.
5. Verificați următoarea repornire planificată
Pasul 8: Confirmați finalizarea opririi și repunerea în funcțiune a serverului
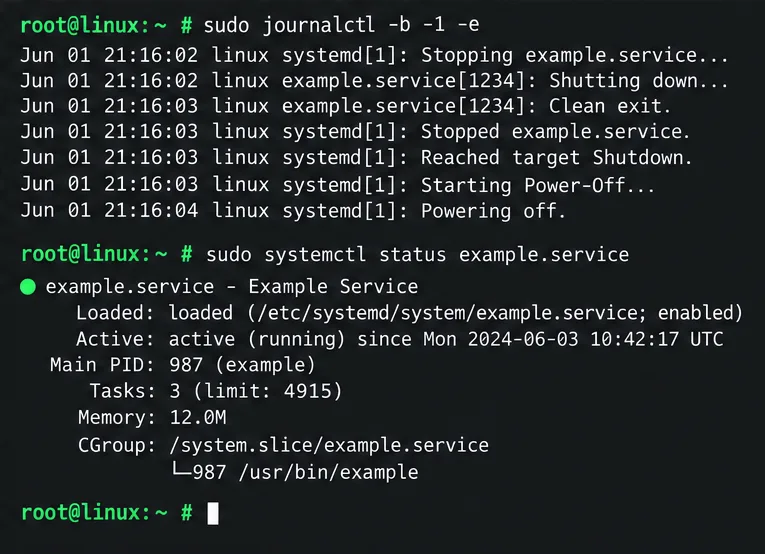
După ce cauza suspectată este corectată, programați o repornire controlată cu acces la consolă disponibil. După ce mașina revine, inspectați mesajele finale ale bootării anterioare și verificați starea curentă a serviciului:
sudo journalctl -b -1 -e
sudo systemctl status SERVICE.service
După o repornire ulterioară, verificați dacă închiderea anterioară a atins mesajele finale și că serviciul este din nou funcțional; aceasta este o vizualizare exemplu, nu o dovadă de testare.
Problema este rezolvată atunci când serverul se oprește fără a aștepta aceeași unitate, pornește normal, iar serviciul sau montarea funcționează. Dacă jurnalele se termină brusc sau afișează erori de kernel, controler sau hardware, păstrați-le și investigați-le cu SUSE sau cu furnizorul de hardware în loc să reglați timeout-urile.
Pentru detalii despre comenzi, consultați ghidul systemd pentru SLES 15 SP7 și ghidul SUSE despre jurnalele persistente și filtrele journalctl . Acești pași identifică posibilele blocante; remedierea corectă pentru serviciu, sistem de fișiere sau hardware depinde de unitatea numită de jurnalele proprii ale mașinii.