Acasă
» Cum să
»
Mențineți serviciile disponibile în timpul unei actualizări de la SLES 15 SP5 la SP6
Mențineți serviciile disponibile în timpul unei actualizări de la SLES 15 SP5 la SP6
O fereastră scurtă de mentenanță este dificil de programat atunci când un server SLES rulează un serviciu orientat către client. SUSE acceptă migrarea online a pachetelor de service de la SLES 15 SP5 la SP6, dar mașina actualizată are nevoie în continuare de o repornire; „online” nu înseamnă fără repornire. Pentru a menține o aplicație accesibilă, actualizați nodurile redundante unul câte unul sau construiți un înlocuitor SP6 și mutați traficul către acesta. Un singur server nu își poate menține propriul sistem de operare disponibil în timp ce repornește.
Scenariu ilustrativ: O echipă fictivă rulează o aplicație web pe trei noduri SLES 15 SP5 în spatele unui echilibrator de încărcare. Aplicația poate deservi cereri de la celelalte două noduri în timp ce un nod este întreținut. Secvența de mai jos arată cum ar putea echipa respectivă migra clusterul; este un exemplu, nu o afirmație că a fost efectuat un test sau că fiecare cluster poate tolera o întrerupere a serviciului unui nod.
1. Alegeți o cale care corespunde serviciului
Pentru o migrare de la SLES 15 SP5 la SP6, SUSE documentează atât metodele de actualizare online, cât și cele offline. Metoda online utilizează migrarea YaST sau zypper migrationîn timp ce sistemul de operare rulează, apoi necesită o repornire a sistemului după migrare. Modificările pachetului pot, de asemenea, să repornească serviciile, așadar migrarea online singură nu poate garanta continuitatea aplicației.
Utilizați procedura de actualizare continuă SLE High Availability numai dacă sarcina de lucru este deja protejată de un cluster sănătos și acceptat. Clusterul trebuie să păstreze cvorumul și o capacitate suficientă pentru a rula serviciul cu un nod offline. Un echilibrator de sarcină obișnuit fără redundanță a aplicațiilor sau un cluster cu două noduri care pierde cvorumul atunci când un nod se oprește nu este suficient. Dacă serverul este independent, utilizați o gazdă SP6 paralelă și o trecere testată a sarcinii de lucru/date pentru a menține accesibilitatea; în caz contrar, programați o perioadă de nefuncționare pentru repornirea acesteia.
Vizualizare ilustrativă a comenzilor pentru verificarea stării de sănătate a clusterului înainte de scoaterea din funcțiune a unui nod.
2. Verificați ținta și pregătiți un plan de recuperare
Înainte de a atinge clusterul, verificați versiunea de pornire, înregistrarea, depozitele și extensiile acceptate. SUSE listează SLES 15 SP5 la SP6 ca o cale acceptată. Migrarea online necesită ca mașina să fie înregistrată la Centrul pentru clienți SUSE sau la un server RMT local; clienții SUSE Manager trebuie să utilizeze procedura de migrare a clientului Manager în loc să o ruleze zypper migrationdirect. Ținta disponibilă poate depinde de produsele și extensiile înregistrate.
Începând cu 1 ianuarie 2026, informațiile despre lansarea SUSE menționează că SLES 15 SP6 a fost mutat pe LTSS. Verificați dacă abonamentul și sursa de înregistrare expun în prezent ținta SP6 înainte de a programa această migrare specifică. Dacă nu este oferită, nu forțați o modificare a depozitului pentru a imita o migrare acceptată.
Faceți o copie de rezervă a datelor și configurației aplicației utilizând metoda acceptată de aplicație și confirmați că le puteți restaura. Consultați ghidul de actualizare SLE HA și notele de lansare SP6 pentru extensii, baze de date, spațiu de stocare și hardware. În clusterul fictiv, operatorul verifică, de asemenea, cvorumul, fencing-ul, starea replicării, capacitatea de rezervă, verificările de stare a echilibratorului de încărcare și o modalitate testată de a muta traficul departe de fiecare nod. O instantanee poate ajuta la revenirea la configurațiile rădăcină Btrfs acceptate, dar nu înlocuiește copiile de rezervă ale aplicației sau bazei de date.
Comandă de migrare ilustrativă; executați-o pe nodul care este actualizat după confirmarea disponibilității țintei.
3. Actualizați câte un nod golit odată
Pentru fiecare nod, urmați procedura de actualizare continuă SLE HA și registrul de operare al clusterului. Nu actualizați niciodată mai multe noduri simultan, cu excepția cazului în care procedura specifică produsului permite în mod explicit acest lucru.
Confirmați că nodurile rămase pot deservi sarcina de lucru. Verificați starea aplicației și starea clusterului. Mutați sau drenați traficul din nod utilizând controalele documentate pentru echilibratorul de sarcină și resursele clusterului. Nu continuați dacă nodurile rămase nu pot păstra cvorumul sau nu pot atinge capacitatea minimă a serviciului.
Opriți stiva clusterului pe acel nod. SUSE avertizează că lăsarea managerului de resurse al clusterului activ în timpul actualizării software-ului poate cauza blocarea nodurilor active. Pe nodul selectat pentru întreținere, executați:
sudo crm cluster stop
Comandă ilustrativă pentru oprirea stivei de cluster pe nodul care este actualizat, așa cum este cerut de procedura de actualizare continuă.
Porniți migrarea pachetului service pack și inspectați propunerea. Rulați comanda documentată de migrare Zypper:
sudo zypper migration
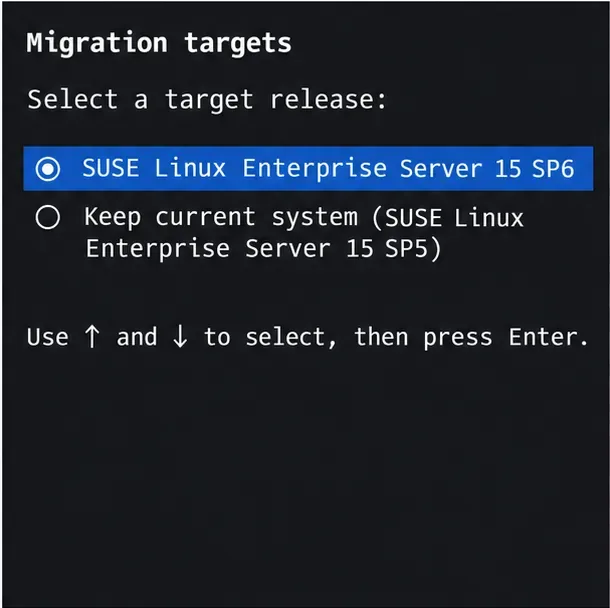
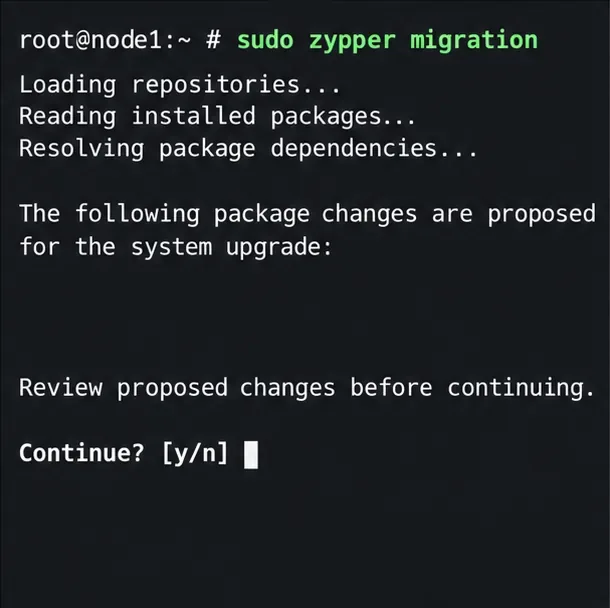
Selectați SLES 15 SP6 numai dacă apare ca o țintă disponibilă. Citiți depozitul și planul pachetului, în special pachetele propuse pentru eliminare sau downgrade și opriți dacă modificările sunt neașteptate. Nu acceptați un plan pe care nu l-ați revizuit. Lista exactă de pachete variază în funcție de software-ul instalat și extensiile înregistrate.
Vizualizare ilustrativă a selecției țintelor; verificați produsul și pachetul de servicii oferite pentru gazda specifică.Exemplu ilustrativ de verificare a pachetului: verificați eliminările, retrogradările și modificările aduse depozitului înainte de a continua.
Reporniți nodul actualizat. După ce Zypper raportează o migrare reușită, reporniți mașina astfel încât să pornească kernelul și serviciile SP6:
sudo reboot
Pas ilustrativ de repornire; acest nod nu va fi disponibil în timpul repornirii, așadar nodurile rămase din cluster trebuie să suporte serviciul.
Reconectați-vă și verificați înainte de a trece la următorul nod. După ce nodul revine, porniți stiva clusterului său:
sudo crm cluster start
sudo crm status
Așteptați până când clusterul raportează că nodul s-a alăturat și că resursele sunt sănătoase, apoi restaurați-l în serviciu conform runbook-ului. Verificați aplicația din afara clusterului. Abia apoi repetați procesul pentru următorul nod. SUSE permite versiuni mixte doar pentru scurt timp în timpul unei actualizări continue și instruiește administratorii să finalizeze actualizarea clusterului în termen de o săptămână.
Comandă ilustrativă de reconectare la cluster pentru nod după ce a pornit SLES 15 SP6.Comandă de verificare ilustrativă pentru a verifica starea clusterului înainte de a trece la următorul nod.
4. Verificați serviciul, nu doar eticheta sistemului de operare
După ce toate nodurile sunt actualizate, confirmați lansarea lor cu cat /etc/os-release, inspectați starea de sănătate a clusterului cu crm statusși verificați unitățile systemd eșuate cu systemctl --failed. Apoi, testați aplicația reală prin adresa sa normală orientată către client, inclusiv verificările de sănătate, accesul la baza de date sau spațiul de stocare și orice joburi programate care contează pentru utilizatori. Examinați jurnalele de migrare și confirmați că depozitele și extensiile așteptate sunt active pe fiecare nod.