Montați o partajare SMB/CIFS în ownCloud fără o montare Linux
Conectați o partajare de rețea Windows sau Samba la ownCloud prin intermediul spațiului de stocare extern, verificați acreditările și depanați în siguranță folderele inaccesibile.
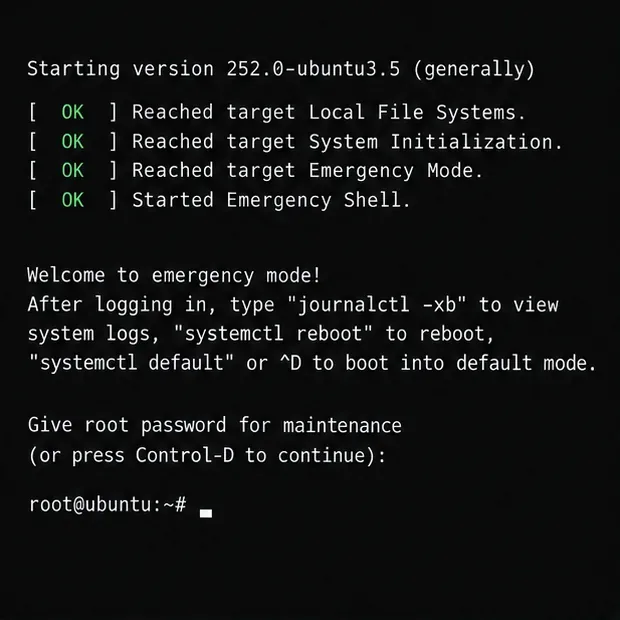
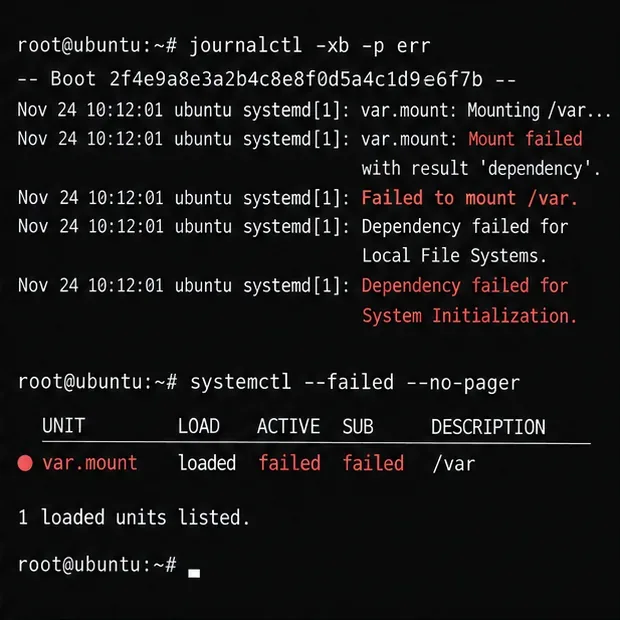
Scenariu ilustrativ: Casey întreține o mașină virtuală ipotetică Ubuntu Server care intră în modul de urgență după o repornire, la scurt timp după ce a fost adăugată o montare opțională a unui volum de date la /etc/fstab. Casey are acces la consolă, dar nu are sesiune SSH. Modificarea montării este o pistă, nu o cauză dovedită: modul de urgență poate apărea în urma mai multor eșecuri de pornire, așa că Casey verifică jurnalele mașinii curente înainte de a modifica ceva. Panourile terminalului de mai jos prezintă machete reprezentative și ieșiri temporare, nu o reparație sau un test real.
Pe o instalare Ubuntu Server folosind systemd, emergency.targetpornește o shell minimală pe consola principală. Este mai limitată decât rescue.target, care afișează sistemul de bază și montările sistemului doar cu serviciile esențiale. În funcție de calea către modul de urgență, sistemul de fișiere rădăcină poate fi deja montat doar pentru citire sau citire-scriere. Verificați-l în loc să presupuneți oricare dintre stări. Consultați documentația systemd special-target din amonte .
Mai întâi distingeți promptul. O shell de urgență systemd spune de obicei „Bun venit în modul de urgență!” și poate solicita parola de root pentru mentenanță. Un prompt BusyBox, cum ar fi , (initramfs)înseamnă că boot-ul nu a comutat încă la sistemul de fișiere root instalat; un prompt grub>sau grub rescue>indică o problemă a încărcătorului de boot. Acestea necesită căi de recuperare diferite. Dacă contul de root este blocat sau serverul este la distanță, utilizați consola serială/VNC a furnizorului de găzduire sau mediul de salvare; SSH nu este de obicei disponibil în această etapă. Nu apăsați Ctrl+D pentru a continua până când nu înțelegeți și nu remediați eroarea raportată.
Rămâneți în consola de urgență. Notați ultima montare eșuată sau numele serviciului și orice cale de dispozitiv sau UUID imprimat deasupra promptului. fstabMerită verificată editarea recentă a lui Casey, dar nu comentați fiecare linie eșuată și nu executați o comandă de reparare bazată doar pe cuvântul „urgență”. Dacă sistemul este o mașină virtuală, mențineți consola furnizorului deschisă în timpul reparării și al următoarei reporniri.
În shell-ul de urgență, executați:
journalctl -xb -p err --no-pager
systemctl --failed --no-pager-blimitează interogarea jurnalului la această bootare și -p errfiltrează după prioritatea erorii și o prioritate mai mare. Căutați prima eroare relevantă, nu doar ultima cascadă de mesaje „dependență eșuată”. Dacă o unitate de montare a eșuat, notați numele unității sale cu caractere escape și calea țintă; dacă un serviciu a eșuat, identificați dacă este o cauză sau doar o consecință a unei montări lipsă. journalctl(1)Manualul Ubuntu documentează bootarea și filtrarea unităților.
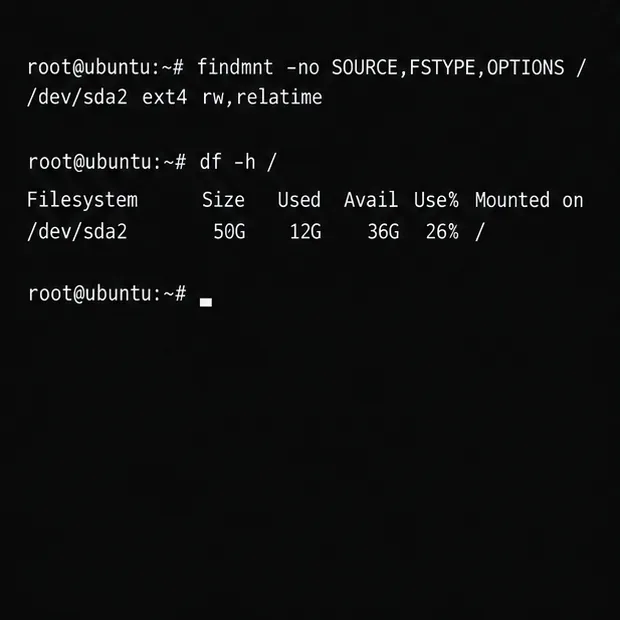
Înainte de a edita fișiere sau de a încerca reparații, verificați cum este montat sistemul de fișiere rădăcină și dacă sistemul a rămas fără blocuri sau inode-uri:
findmnt -no SOURCE,FSTYPE,OPTIONS /
df -h /
df -i /
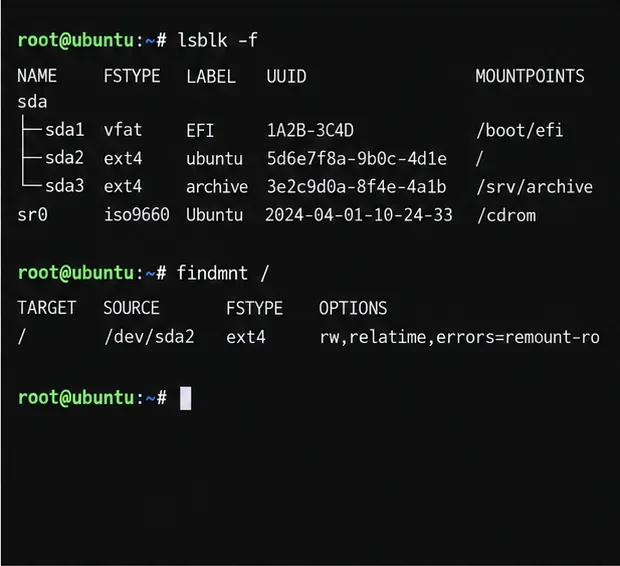
În findmntrezultat, roînseamnă doar citire și rwînseamnă citire-scriere. O utilizare root doar citire poate fi intenționată în timpul unei părți a unei căi de recuperare sau poate reflecta o problemă a sistemului de fișiere. Nu forțați imediat o remontare ca citire-scriere dacă jurnalele kernelului raportează erori I/O sau ale sistemului de fișiere. Un sistem de fișiere plin sau o tabelă de inode epuizată poate cauza, de asemenea, eșecul serviciilor și montărilor fără legătură. Manualul Ubuntu findmnt(8)descrie cum se inspectează sistemele de fișiere montate.
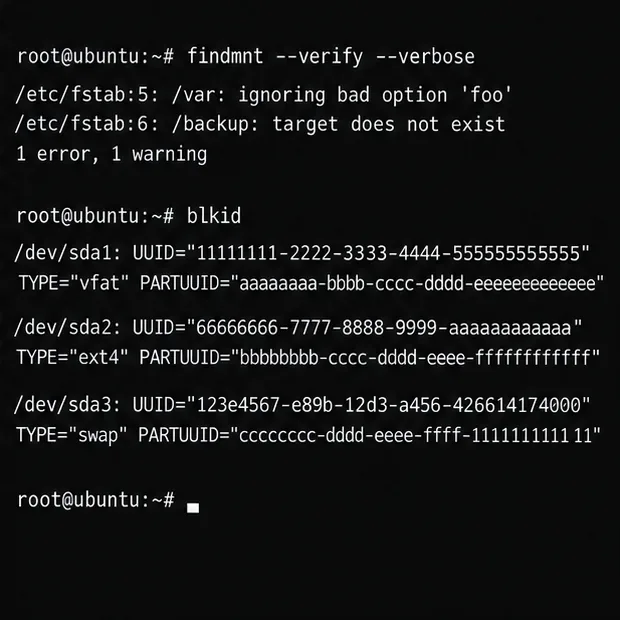
/etc/fstabși verificați identificatorii dispozitivuluiDeoarece Casey a modificat recent /etc/fstab, verificați atât sintaxa sa, cât și dacă există dispozitivele la care se face referire:
findmnt --verify --verbose
lsblk -f
blkid
findmnt --verify --verboseverifică intrările fstab pentru probleme de analiză și utilizabilitate. Comparați fiecare element UUID=din rândul suspect cu UUID-ul afișat de lsblk -fsau blkid. Verificați și punctul de montare, tipul sistemului de fișiere și opțiunile. Un UUID copiat de pe alt disc, un dispozitiv care nu este atașat sau o opțiune nevalidă poate împiedica finalizarea unei montări necesare. Nu ghiciți o partiție, cum ar fi /dev/sda1; numele dispozitivelor se pot schimba între porniri.
Dacă sistemul de fișiere rădăcină este inscriptibil și verificarea fstab identifică un rând greșit, faceți o copie de rezervă înainte de editare:
cp -a /etc/fstab /etc/fstab.before-rescue
nano /etc/fstab
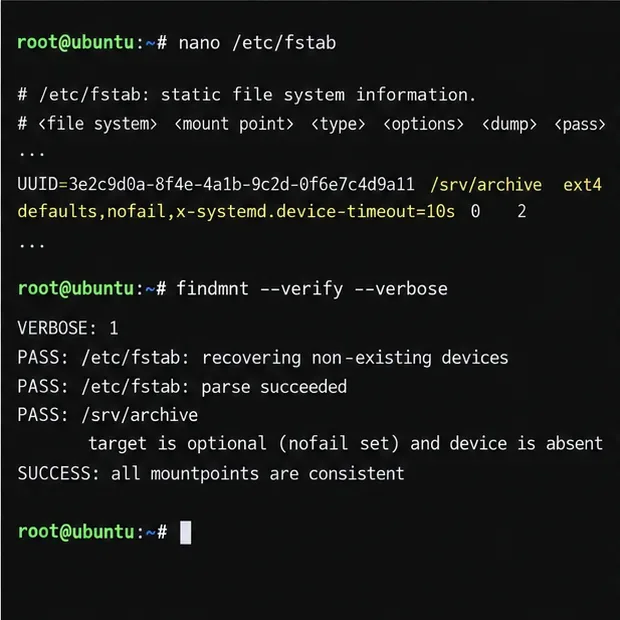
Corectați UUID-ul sau alt câmp numai după confirmarea dispozitivului dorit. Dacă montarea este într-adevăr opțională și serverul ar trebui să pornească în continuare chiar și atunci când volumul respectiv este absent, o linie fstab compatibilă cu systemd poate utiliza nofailși o așteptare finită pentru dispozitiv, de exemplu:
UUID=VERIFIED-UUID /srv/archive ext4 defaults,nofail,x-systemd.device-timeout=10s 0 2Înlocuiți substituentul cu UUID-ul real și utilizați tipul real al sistemului de fișiere. Nu adăugați nofailla root, boot sau alte sisteme de fișiere necesare pentru ca mașina sau aplicațiile sale să funcționeze corect. Cu nofail, boot-ul continuă chiar dacă montarea eșuează, deci serviciile dependente pot necesita în continuare atenție. Manualul Ubuntu systemd mount-unit documentează aceste opțiuni fstab.
După editare, validați din nou înainte de a încerca montarea:
findmnt --verify --verbose
systemctl daemon-reload
mount /srv/archive
Folosește punctul de montare real din ultima comandă. Dacă eșuează în continuare, citește noua eroare și verifică dacă discul este atașat și funcțional. Dacă sistemul de fișiere rădăcină este doar pentru citire, nu forța modificările orbește; folosește un mediu de recuperare de la furnizor sau un mediu de stocare Ubuntu bootabil pentru a inspecta și edita sistemul instalat în siguranță.
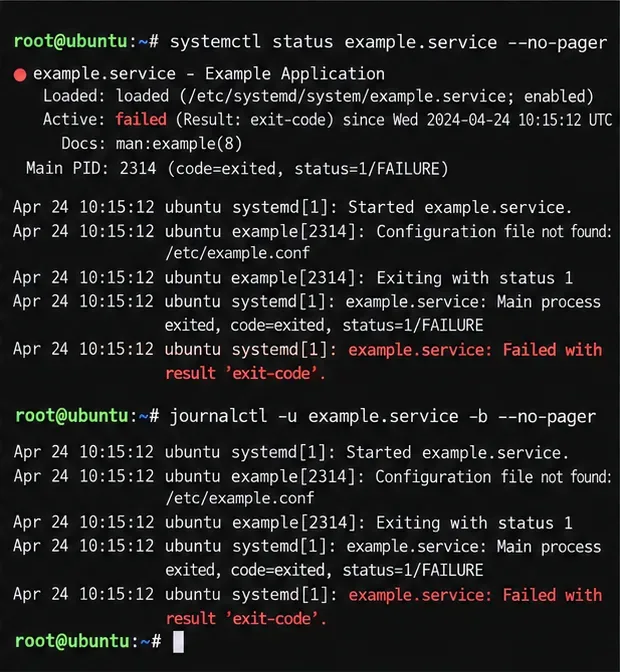
Modul de urgență nu înseamnă că fiecare serviciu eșuat a cauzat oprirea bootării. Dacă eroarea relevantă denumește un serviciu, inspectați acea unitate și jurnalele sale în loc să o mascați sau să o dezactivați:
systemctl status example.service --no-pager
journalctl -u example.service -b --no-pager
Înlocuiți example.servicecu numele exact al unității. Verificați dacă lipsește fișierul de configurare, executabilul, acreditările sau montarea necesară. Dacă eroarea este în aval de volumul de date lipsă al lui Casey, remediați mai întâi montarea respectivă și apoi reevaluați serviciul. Dezactivarea unui serviciu esențial poate ascunde simptomul, lăsând serverul inutilizabil.
Dacă jurnalul kernelului raportează coruperea sistemului de fișiere sau erori I/O de stocare, opriți scrierile acolo unde este practic și păstrați o copie de rezervă sau o instantanee a furnizorului înainte de reparare. Confirmați dispozitivul și sistemul de fișiere exacte cu lsblk -f. Pentru un sistem de fișiere root, porniți în sistemul de salvare al furnizorului sau în mediul de recuperare/live Ubuntu, asigurați-vă că partiția țintă este demontată și utilizați verificatorul corespunzător sistemului de fișiere respectiv. Pentru ext2/3/4, instrumentul respectiv este e2fsck; XFS, Btrfs și alte formate au proceduri diferite.
Nu rulați niciodată fsckpe e2fsckun sistem de fișiere montat, inclusiv pe un sistem root montat cu acces doar pentru citire. e2fsck(8)Manualul Ubuntu avertizează că verificarea unui sistem de fișiere montat este, în general, nesigură și că rezultatele nu sunt valide. Dacă discul raportează erori I/O repetate, acordați prioritate recuperării datelor sau implicării furnizorului de stocare față de încercările repetate de reparații.
După ce cauza confirmată este corectată, reporniți din consolă:
systemctl rebootDupă ce pornește Ubuntu, verificați ținta implicită configurată, starea curentă a sistemului, unitățile defecte și noua versiune de boot:
systemctl get-default
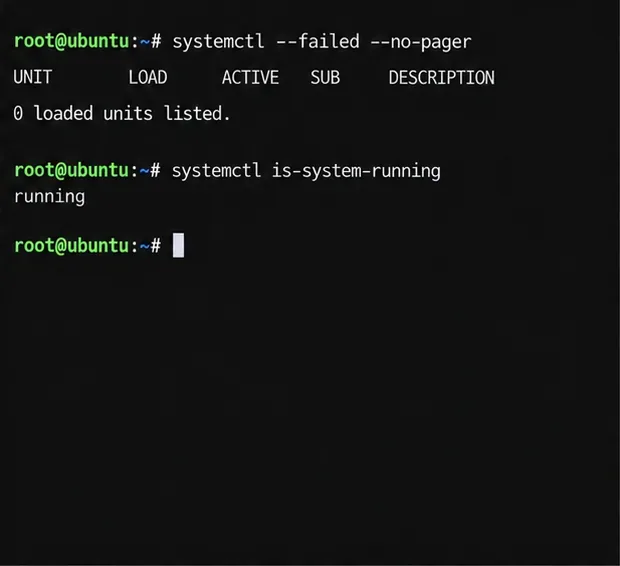
systemctl is-system-running
systemctl --failed --no-pager
journalctl -b -p err --no-pager
findmnt --verify --verbose
Dacă continuați intenționat în bootarea curentă, systemctl defaultsolicită sistemului systemd să pornească ținta implicită configurată. Folosiți-o numai după ce eroarea de blocare este remediată; nu repară o montare invalidă sau un sistem de fișiere deteriorat. systemctl get-defaultafișează ținta implicită configurată; systemctl is-system-runningraportează dacă systemd consideră starea curentă ca fiind în funcțiune, degradată sau altfel. O recuperare curată înseamnă că sistemele de fișiere așteptate sunt montate, serviciile necesare sunt active și aceeași condiție de urgență nu se repetă după repornire.
(initramfs)în schimbNu aplicați orbește pașii de urgență ai shell-ului systemd în BusyBox initramfs. Etapa initramfs încearcă să localizeze și să monteze sistemul de fișiere rădăcină real înainte de a preda controlul sistemului instalat. Înregistrați eroarea exactă, verificați dacă dispozitivul așteptat apare în /devși /dev/disk/by-uuidși comparați valoarea liniei de comandă de boot root=cu UUID-ul rădăcină real. Dacă discul sau volumul criptat/LVM lipsește, utilizați instrumentele de stocare și salvare ale furnizorului pentru a-l investiga. Reconstruirea initramfs sau modificarea parametrilor GRUB fără a identifica dispozitivul lipsă poate îngreuna recuperarea la boot.
Pentru mașina virtuală ipotetică a lui Casey, rezultatul util este o cauză verificată și o corecție cu un domeniu de aplicare restrâns: restaurați volumul opțional așteptat, corectați identificatorul său confirmat sau configurați-l ca opțional numai dacă sarcina de lucru permite cu adevărat acest lucru. Apoi verificați următoarea pornire din consolă înainte de a închide sesiunea de recuperare.
Conectați o partajare de rețea Windows sau Samba la ownCloud prin intermediul spațiului de stocare extern, verificați acreditările și depanați în siguranță folderele inaccesibile.
Eliminați fiecare versiune de fișier ownCloud Server Classic stocată pentru un cont sau pentru toți utilizatorii și faceți diferența între o eliminare completă și o expirare bazată pe retenție.
Urmăriți un refuz al conexiunii mobile ownCloud verificând adresa URL a serverului, rețeaua telefonică, endpoint-ul HTTPS și jurnalele serverului în ordinea corectă.
Înlocuiți rularea joburilor la cerere cu un cronometru systemd care rulează comanda occ system:cron acceptată de ownCloud la fiecare 15 minute.
Urmăriți cererea WebDAV prin Apache, Nginx sau un proxy invers, apoi confirmați că sincronizarea ownCloud funcționează cu un test PROPFIND autentificat.
Remediați avertismentul privind lipsa adresei de ieșire din Nextcloud prin setarea adresei URL canonice și verificarea DNS, HTTPS și a rutării reverse-proxy de pe server.
Configurați APCu și Redis printr-un socket Unix local pentru cache-ul Nextcloud și blocarea fișierelor, cu pași pentru versiunile actuale și mai vechi de Nextcloud.
Verificați modul cron al Nextcloud, reparați serviciul systemd și cronometrul și verificați dacă joburile de fundal rulează după pornire și la fiecare cinci minute.
Activează blocarea fiabilă a fișierelor Nextcloud, alege backend-ul Redis sau Valkey potrivit și verifică dacă avertismentul dispare fără a risca modificări simultane ale fișierelor.
Corectează rezultatele comune ale scanărilor Nextcloud cu actualizări actuale, HTTPS și HSTS, încredere precisă în reverse-proxy și verificări pe serverul public.