Acasă
» Cum să
»
SLES Thin Pool fără spațiu: Extindeți LVM în siguranță și restaurați scrierile
SLES Thin Pool fără spațiu: Extindeți LVM în siguranță și restaurați scrierile
Când un volum cu alocare subțire SUSE Linux Enterprise Server raportează „nu mai este spațiu disponibil pe dispozitiv”, verificați mai întâi pool-ul subțire Data%și Meta%. Dacă zona de date este plină și grupul de volume are extensii libere, extindeți pool-ul subțire cu lvextend— nu doar cu dimensiunea virtuală a volumului său logic subțire. O zonă de metadate complet plină este diferită: poate necesita reparare offline înainte de reluarea scrierilor normale.
Procedura de mai jos utilizează comenzile LVM2 documentate pentru Linux și modelul de stocare descris în Ghidul de administrare a stocării SUSE Linux Enterprise Server 15 SP7 . Disponibilitatea comenzilor și configurația serviciilor pot diferi în funcție de un alt pachet service pack SLES sau de o instalare în cluster. Realizați o copie de rezervă consistentă cu aplicația și restricționați scrierile intense înainte de a modifica stocarea de producție.
1. Verificați dacă spațiul de date sau metadatele sunt epuizate
Executați următoarele pe gazda care deține pool-ul subțire activ, înlocuind vgdatacu numele grupului de volume:
sudo lvs -a -o lv_name,lv_size,segtype,data_percent,metadata_percent,pool_lv vgdata
Căutați rândul cu thin-poolsub SegType. Data%măsoară blocurile de date alocate; Meta%măsoară metadatele de mapare ale pool-ului. Acestea sunt limite de capacitate separate. Dacă Data%este aproape de 100, dar Meta%este confortabil sub acesta, extensiile de date suplimentare reprezintă cea mai directă soluție. Dacă Meta%este la 100, utilizați precauțiile de recuperare din secțiunea 4.
Exemplu de vizualizare în terminal: valoarea Data% a pool-ului este aproape plină, în timp ce utilizarea metadatelor este mult mai mică. Valorile ilustrează câmpurile de inspectat, nu un rezultat de diagnosticare live.
Pentru un exemplu ipotetic , să presupunem că vgdata/pool0avem 100 GiB cu o utilizare a datelor de 98,12% și o utilizare a metadatelor de 40,26%. Pool-ul este expus unui risc imediat, chiar dacă df -hraportează suficient spațiu în interiorul unui volum subțire montat. Dimensiunea virtuală a unui volum subțire poate depăși capacitatea fizică care susține pool-ul, așa cum explică documentația Expert Partitioner de la SUSE .
Nu interpretați un rezultat grep gol ca dovadă că nu au avut loc scrieri eșuate. Verificați și jurnalele aplicației, mai ales dacă o bază de date sau o mașină virtuală scria atunci când pool-ul s-a umplut.
2. Confirmați că grupul de volume are extensii fizice libere
Înainte de a modifica dimensiunea pool-ului, aflați dacă grupul de volume poate finanța extensia:
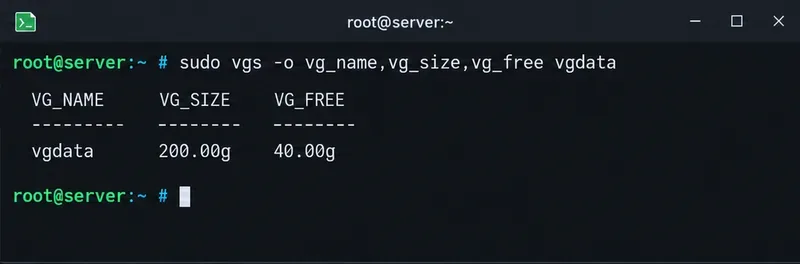
sudo vgs -o vg_name,vg_size,vg_free vgdata
Exemplu de verificare a grupului de volume: VG_FREE indică dacă sunt disponibile extensii fizice pentru a mări pool0 fără a adăuga un alt dispozitiv.
În exemplul ipotetic, grupul de volume de 200 GiB are 40 GiB liberi. Prin urmare, o extensie a pool-ului de 20 GiB este fezabilă în principiu, sub rezerva constrângerilor de alocare și a spațiului pentru orice creștere a metadatelor. Păstrați o parte din spațiul VG în rezervă, în loc să alocați fiecare extensie liberă pool-ului.
Dacă VG_FREEeste zero, lvextendnu se poate inventa capacitatea fizică. Adăugați un volum fizic identificat și pregătit corect la VG, măriți spațiul de stocare subiacent și PV-ul LVM, după caz, sau recuperați blocuri înainte de a reîncerca. SUSE documentează adăugarea de volume fizice la redimensionarea unui grup de volume . Nu rulați niciodată pvcreatepe un disc neverificat: poate distruge metadatele de stocare existente.
3. Extindeți piscina subțire în loc de volumul subțire
Când Data%este factorul limitativ, metadatele nu sunt epuizate și sunt libere suficiente extensii VG, extindeți pool-ul în sine:
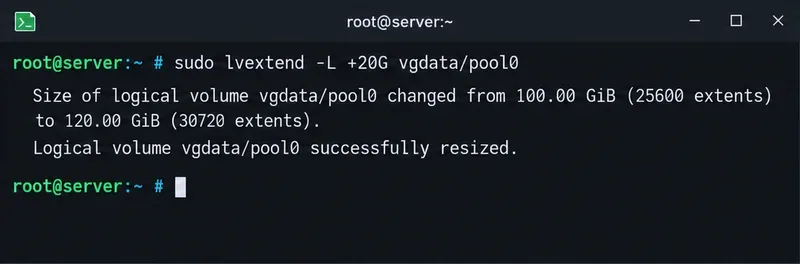
sudo lvextend -L +20G vgdata/pool0
Exemplu de extensie thin-pool: comanda vizează vgdata/pool0, nu volumul logic subțire din interiorul acestuia. Răspunsul afișat este ilustrativ.
Sintaxa +20Gadaugă 20 GiB la dimensiunea curentă a pool-ului; nu setează dimensiunea finală la 20 GiB. În acest exemplu, pool-ul de rezervă crește de la 100 GiB la 120 GiB. Cu date alocate neschimbate, 98,12 GiB în utilizare ar reprezenta aproximativ 81,8% din pool-ul extins. Procentul real poate diferi dacă scrierile continuă în timpul operației.
Nu înlocuiți .lvextend -L +20G vgdata/thin1 Mărirea spațiului de adrese virtuale al unui volum subțire nu adaugă neapărat capacitate fizică de date la pool-ul său. Deoarece această comandă extinde pool-ul de rezervă în loc de dispozitivul bloc virtual al sistemului de fișiere, o redimensionare a sistemului de fișiere nu este în mod normal necesară pentru această operațiune specifică. Manualul autorizat de furnizare subțire LVM documentează mecanismul de extindere a pool-ului subțire și limitele acestuia.
Când nu puteți extinde piscina imediat
Dacă fișierele au fost deja șterse dintr-un sistem de fișiere subțire și eliminarea este acceptată de întreaga stivă, luați în considerare recuperarea blocurilor eliminate:
sudo fstrim -v /srv/data
Folosește punctul de montare real al unui volum subțire, nu dispozitivul din pool-ul subțire. O decupare reușită poate reduce Data%, dar ștergerea fișierelor în sine nu returnează, de obicei, blocuri în pool. Snapshot-urile subțiri pot păstra blocuri partajate, iar un pool setat să ignore eliminările nu va beneficia de acest lucru. Nu trata decuparea ca pe un substitut de urgență fiabil pentru capacitatea fizică, în special dacă scrierile au început să eșueze. Elimină snapshot-urile vechi numai după ce le verifici proprietatea, dependențele și cerințele de păstrare; ștergerea snapshot-urilor este ireversibilă.
4. Tratați o zonă completă de metadate ca o condiție de recuperare
Dacă Meta%a ajuns la 100%, opriți scrierile aplicației și planificați o întrerupere controlată. LVM avertizează că epuizarea metadatelor poate face ca metadatele pool-ului subțire și sistemele de fișiere să fie inconsistente. Simpla creștere a dimensiunii datelor pool-ului, reîncercarea scrierilor sau activarea forțată nu rezolvă acest risc.
Secvența de recuperare documentată constă în dezactivarea offline a pool-ului afectat, repararea metadatelor sale subțiri folosind lvconvert --repair VG/ThinPool, mărirea capacității metadatelor folosind lvextend --poolmetadatasizeși apoi verificarea fiecărui sistem de fișiere afectat cu instrumentul offline corespunzător. De exemplu, un pool al cărui LV de metadate este mai mic de 2 GiB ar putea necesita o țintă revizuită, cum ar fi:
sudo lvextend --poolmetadatasize 2G vgdata/pool0
Aceasta nu este o comandă de executat orbește pe un pool activ și deteriorat. Dimensiunea sa este un exemplu, nu o cerință universală. Confirmați mai întâi dimensiunea actuală a metadatelor, extensiile disponibile, dezactivarea corectă, mediile de recuperare și copiile de rezervă. lvconvert --repairtrebuie planificată cu expertiză în timp de nefuncționare și recuperare; manualul LVM notează că este posibil să eșueze, iar datele pot fi în continuare irecuperabile. Păstrați vechiul LV de metadate până când pool-ul și sistemele de fișiere au fost verificate. O copie de rezervă a configurației LVM de la vgcfgbackupnu face backup la metadatele thin-pool. Pentru datele critice pentru afacere, implicați asistența SUSE sau echipa de recuperare a stocării înainte de a încerca repararea.
5. Activați extensia automată, apoi verificați scrierile
După ce sistemul este stabil, configurați o politică de creștere proactivă în activationsecțiunea /etc/lvm/lvm.conf. Acest exemplu începe extensia la o utilizare de 70% și solicită o creștere de 20%; ajustați aceste valori pentru rata de scriere și capacitatea VG disponibilă:
Asigurați-vă că setările sunt aplicate domeniului de configurare corect și că pool-ul este monitorizat:
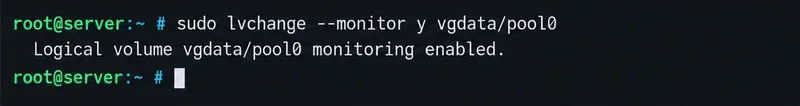
sudo lvchange --monitor y vgdata/pool0
Exemplu de comandă de monitorizare: activarea monitorizării evenimentelor LVM permite politicilor automate de creștere a pool-ului să acționeze atunci când rămân suficiente extensii libere.
Creșterea automată a pool-urilor subțiri depinde de monitorizarea evenimentelor LVM ( dmeventd) și de suficiente extensii libere. Verificați serviciul de monitorizare furnizat de instalarea SLES - de exemplu, systemctl status lvm2-monitorunde există acea unitate - și examinați jurnalele sale. Un prag nu garantează protecția dacă extensia depășește scrierile sau dacă VG este deja plin. Consultați ghidul de extensie automată din manualul LVM și opțiunile de monitorizare lvchange .
Verificați dacă remedierea a funcționat
Citiți atât gradul de utilizare a pool-ului, cât și capacitatea rămasă a VG:
Data%ar fi trebuit să se fi întrerupt după extinderea pool-ului de date, Meta%trebuie să rămână sub epuizare, iar pool-ul ar trebui să fie activ fără noi erori I/O. Verificați starea sistemului de fișiere și jurnalele aplicației, apoi efectuați un test de scriere și citire restrâns, adecvat aplicației, înainte de a elibera sarcinile de lucru suspendate. Dacă erorile persistă după ce spațiul este disponibil, mențineți sarcina de lucru afectată offline până când integritatea sistemului de fișiere și a aplicației au fost evaluate; o capacitate mai mare nu poate inversa scrierile deja eșuate sau pierdute.