Acasă
» Tehnologie
»
Ce cauzează întreruperile pe scară largă ale platformei cloud? Tiparele de defecțiuni din spatele întreruperilor majore
Ce cauzează întreruperile pe scară largă ale platformei cloud? Tiparele de defecțiuni din spatele întreruperilor majore
Nefuncționarea pe scară largă a platformei cloud este rareori cauzată de simpla „nefuncționare” a unui singur server. Cele mai perturbatoare incidente încep de obicei cu o singură eroare tehnică - o configurație greșită, un defect software, o problemă DNS, o eroare de rețea sau un eveniment de infrastructură - și apoi se răspândesc deoarece multe servicii depind de aceleași planuri de control, baze de date, sisteme de identitate, echilibratoare de sarcină sau resurse regionale.
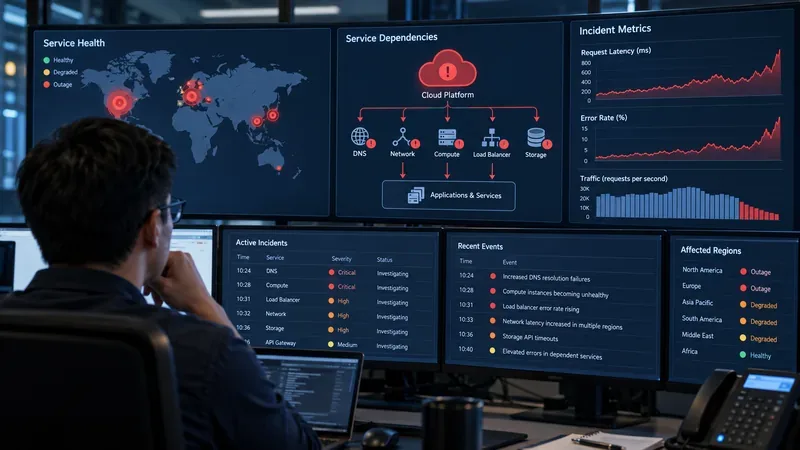
Scenariu ilustrativ: imaginați-vă un furnizor fictiv de cloud numit Northstar Cloud. La ora 10:05, o modificare automată a rețelei este aplicată unui serviciu regional. În câteva minute, clienții încep să raporteze apeluri API eșuate. La ora 10:12, noile mașini virtuale se opresc din lansare. La ora 10:20, echilibratoarele de sarcină încep să marcheze backend-urile sănătoase ca fiind indisponibile. Până la ora 10:35, zeci de produse care par a nu avea legătură sunt degradate. Acest scenariu este ipotetic, nu o descriere a unei întreruperi reale. Este util deoarece arată de ce o mică eroare inițiatoră poate deveni un eveniment major al platformei.
Echipele de operațiuni în cloud trebuie adesea să urmărească o întrerupere de la prima dependență defectă prin DNS, rețea, calcul, echilibrarea încărcării, stocare și aplicații downstream.
Răspunsul scurt: întreruperile majore ale cloud-ului sunt de obicei defecțiuni în cascadă.
Principalele cauze ale întreruperii pe scară largă a platformei cloud sunt erorile de configurare și implementare, defectele software latente, erorile DNS și de rutare, dependențele de servicii partajate, epuizarea capacității în timpul defecțiunii sau recuperării, problemele planului de control și defecțiunile fizice care afectează un centru de date sau o zonă de disponibilitate. Amploarea întreruperii depinde mai puțin de prima eroare și mai mult de cât de mult este partajată componenta afectată.
Un exemplu util din lumea reală vine de la AWS. În rezumatul său oficial post-eveniment pentru întreruperea din octombrie 2025 din Virginia de Nord, AWS a declarat că o condiție de concurență latentă în sistemul automat de gestionare DNS al DynamoDB a produs o înregistrare DNS goală incorectă pentru endpoint-ul regional. Această eroare DNS a afectat clienții și serviciile interne AWS care depindeau de DynamoDB, iar lucrările ulterioare de recuperare au contribuit la probleme legate de lansările EC2 și Network Load Balancers. Incidentul este documentat în rezumatul AWS post-eveniment pentru întreruperea DynamoDB din octombrie 2025 .
1. Modificările de configurație pot crea o rază de explozie neașteptat de mare
Erorile de configurare se numără printre cele mai frecvente tipare în incidentele sistemelor distribuite mari, deoarece platformele moderne sunt controlate prin automatizare. O singură modificare poate fi transmisă către mii de gazde, routere, înregistrări DNS sau endpoint-uri de servicii mai rapid decât ar putea fi atinsă manual de un operator uman.
Revenim la scenariul Northstar Cloud. Să presupunem că modificarea rețelei de la 10:05 a fost destinată pentru zece mașini, dar a fost aplicată mai multor regiuni. Modificarea nu trebuie să distrugă hardware-ul. Poate pur și simplu să elimine capacitatea utilizabilă a rețelei, să modifice rutarea sau să determine sistemele să respingă traficul altfel sănătos. Odată ce capacitatea partajată scade sub cerere, clienții se confruntă cu expirari și reîncercări, ceea ce creează o sarcină și mai mare.
Google a descris un mecanism similar în relatarea sa oficială a unei perturbări a serviciului din 2019: o modificare de configurație destinată unui număr mic de servere dintr-o regiune a fost aplicată incorect pe o scară mult mai largă, determinând mai multe regiuni să nu mai utilizeze mai mult de jumătate din capacitatea disponibilă a rețelei lor. Traficul a congestionat apoi capacitatea rămasă. Consultați actualizarea oficială a Google privind întreruperea serviciului din 2019 .
De aceea, operatorii de cloud maturi utilizează implementări etapizate, validare, reveniri automate, limite ale ratei de modificare și controale de tip „raza de explozie”. Aceste măsuri de siguranță nu elimină incidentele, dar pot împiedica o modificare nedorită să devină un eveniment la nivelul întregii platforme.
2. Defectele software pot rămâne ascunse până când apar condiții de sincronizare rare
Platformele cloud mari rulează flote enorme de software distribuit. Unele defecte rămân inactive timp de luni sau ani, deoarece necesită o secvență rară de evenimente: două controllere care actualizează aceeași stare, o întârziere neobișnuită, metadate învechite sau un proces de recuperare care rulează în același timp cu un proces de curățare.
În incidentul fictiv Northstar, imaginați-vă că doi lucrători de automatizare independenți actualizează același plan DNS. Unul este întârziat, celălalt finalizează o actualizare mai nouă, iar o rutină de curățare elimină apoi datele pe care lucrătorul întârziat tocmai le-a activat. Fiecare componentă individuală poate părea că funcționează conform destinației, dar interacțiunea lor creează o stare invalidă.
Evenimentul AWS DynamoDB din 2025 ilustrează clar această categorie. AWS a atribuit eroarea inițiată unei condiții de concurență latentă între componentele redundante de gestionare DNS. Semnificația este mai amplă decât un furnizor: redundanța îmbunătățește fiabilitatea doar atunci când componentele redundante nu pot corupe starea partajată prin aceeași logică sau prin eroarea de sincronizare.
3. Erorile DNS și de rețea pot face ca sistemele sănătoase să fie inaccesibile
Un serviciu poate fi complet pornit și totuși indisponibil dacă clienții nu pot rezolva numele său de gazdă sau pachetele nu îl pot ajunge. Prin urmare, DNS, rutare, echilibrarea încărcării și configurația rețelei se află pe calea critică pentru aproape fiecare produs cloud.
În exemplul nostru Northstar, clienții ar putea presupune că serviciul de calcul în sine a eșuat din cauza expirării apelurilor API. Însă serverele de calcul reale ar putea fi sănătoase, în timp ce DNS nu returnează niciun punct final utilizabil, lipsește o rută sau un echilibrator de încărcare a eliminat țintele sănătoase.
AWS a documentat acest mod de eroare de mai multe ori. Într-un incident din regiunea Seul din 2018, AWS a declarat că o actualizare de configurație a eliminat incorect o setare care specifica numărul minim de gazde sănătoase pentru flota de resolvere DNS EC2. Capacitatea redusă a resolverului a cauzat apoi eșecul interogărilor DNS de la instanțele EC2. Detaliile se găsesc în rezumatul AWS al problemei de rezoluție DNS EC2 din 2018 la Seul .
De asemenea, erorile de rețea se amplifica rapid deoarece aplicațiile reîncearcă conexiunile eșuate. Comportamentul agresiv de reîncercare poate transforma o afectare parțială a rețelei într-o creștere a traficului mult mai mare.
4. Dependențele partajate fac ca serviciile fără legătură să eșueze împreună
Serviciile cloud nu sunt produse izolate. O bază de date gestionată poate depinde de servicii de identitate, DNS intern, stocare, rețea, sisteme de programare, servicii de certificare și telemetrie. O platformă fără server poate depinde de capacitatea de calcul, rețea, așteptare și baze de date din planul de control. Dacă o dependență partajată eșuează, multe produse se pot degrada în același timp.
Aceasta explică unul dintre cele mai confuze simptome de întrerupere a serviciului: clienții văd erori în mai multe servicii și presupun că au avut loc mai multe erori independente. În realitate, erorile vizibile pot avea toate aceeași cauză în amonte.
În scenariul Northstar, serviciul mașinii virtuale, serviciul container și serviciul serverless ar putea începe să dea greș deoarece se bazează pe aceeași bază de date internă cu resurse. Produsele orientate către client sunt diferite; dependența de sub ele nu este.
Incidentul AWS din octombrie 2025 a arătat acest tip de cascadă atunci când serviciile interne care se bazau pe DynamoDB au fost afectate de problema DNS inițială, urmată de efecte de recuperare în aval în EC2, Network Load Balancer, Lambda, serviciile de containere, funcțiile legate de identitate și alte produse.
5. Recuperarea poate eșua deoarece restanțele sunt mai mari decât sarcina operațională normală
Restaurarea componentei defecte originale nu pune întotdeauna capăt unei întreruperi. În timpul perioadelor de nefuncționare, cozile cresc, contractele de închiriere expiră, verificările de sănătate eșuează, scalatoarele automate solicită capacitate de înlocuire, clienții solicită reîncercare și actualizările de configurare se acumulează. Când dependența eșuată revine, fiecare sistem în așteptare poate încerca să se recupereze simultan.
În exemplul Northstar, să presupunem că DNS este reparat la 10:45. Mii de gazde de calcul încearcă acum să reînnoiască contractele de închiriere expirate. În același timp, clienții reîncearcă implementările eșuate, iar sistemele de scalare automată solicită instanțe de înlocuire. Planul de control procesează brusc de câteva ori volumul de lucru normal. Dacă nu are limite de rată efective sau prioritizare a recuperării, poate intra într-un al doilea mod de eșec, chiar dacă eroarea inițială a dispărut.
AWS a descris o problemă de recuperare comparabilă în 2025: după ce accesul la DynamoDB a fost restabilit, un subsistem EC2 a trebuit să restabilească un număr mare de contracte de închiriere. Restanțele au devenit dificil de procesat înainte de expirarea timpului de așteptare, iar AWS a declarat că subsistemul a intrat într-o stare de „colaps congestiv”. Acest detaliu este important deoarece arată de ce durata întreruperii poate fi mult mai lungă decât timpul necesar pentru a remedia declanșatorul inițial.
6. Verificările de sănătate și failover-ul automat pot uneori elimina capacitatea bună
Verificările stării de funcționare sunt esențiale, dar sunt și factori de decizie automatizați. Dacă o rețea este lentă sau propagarea stării este întârziată, un sistem de verificare a stării de funcționare poate concluziona că resursele sănătoase sunt defecte și le poate elimina din serviciu. Acest lucru poate reduce și mai mult capacitatea, producând o buclă de feedback.
În scenariul fictiv, echilibratoarele de sarcină Northstar încep să verifice instanțele nou lansate înainte ca configurația rețelei să se fi propagat complet. Verificările eșuează, instanțele sănătoase sunt retrase, traficul se mută către mai puține noduri rămase, iar aceste noduri devin supraîncărcate.
Acel tipar a apărut și în timpul evenimentului AWS din 2025. AWS a declarat că verificările de sănătate ale Network Load Balancer au eșuat uneori în timp ce starea rețelei pentru instanțe noi era încă în curs de propagare, ceea ce a dus la eliminarea capacității din serviciu. Aceasta este o reamintire a faptului că logica de failover trebuie să fie limitată în funcție de rată și testată în condiții de eșec parțial, nu doar în condiții „sănătoase/nesănătoase” curate.
7. Defecțiunile centrului de date, ale alimentării, răcirii și zonei de disponibilitate rămân posibile
Nu orice întrerupere de alimentare începe din software. Infrastructura de alimentare, răcire, fibră optică, hardware de rețea și alte infrastructuri fizice pot defecta. Arhitectura cloud este concepută în funcție de această realitate, motiv pentru care furnizorii majori împart regiunile în zone izolate de erori.
Microsoft explică faptul că zonele de disponibilitate Azure sunt grupuri separate de centre de date cu alimentare, răcire și rețea independente. De asemenea, Microsoft notează că o implementare zonală nu supraviețuiește automat unei întreruperi a zonei; clienții trebuie să utilizeze mai multe zone sau servicii redundante de zonă acolo unde este acceptat. Consultați prezentarea generală oficială a zonelor de disponibilitate Azure de la Microsoft .
În termeni practici, un furnizor de cloud poate face o zonă independentă, dar sarcina de lucru a unui client poate avea în continuare o bază de date cu o singură zonă, o singură dependență de control regional sau un proces de failover care nu a fost niciodată exercitat.
De ce o întrerupere a serviciului cloud poate părea globală chiar și atunci când cauza principală este regională
„Întreruperea globală” este adesea o descriere a impactului asupra clientului, nu a locației fizice a echipamentului defect. Un serviciu regional poate oferi suport pentru autentificare, DNS, metadate, creare de conducte, tablouri de bord sau API-uri de control utilizate din alte regiuni. Prin urmare, aplicațiile din întreaga lume pot eșua deoarece depind de un serviciu concentrat într-o singură locație.
Distincția este importantă atunci când se diagnostichează un incident. Inginerii ar trebui să pună două întrebări diferite: Unde a avut loc prima defecțiune? și Ce dependențe au permis răspândirea acelei defecțiuni? Aceste răspunsuri sunt frecvent diferite.
Cum să identifici cauza probabilă în timpul unui incident live
Pentru operatori, cea mai rapidă cale este de obicei corelarea simptomelor, mai degrabă decât investigarea fiecărui produs separat. Dacă mai multe servicii eșuează în același timp, căutați o dependență partajată. Dacă sarcinile de lucru existente rămân sănătoase în timp ce noile implementări eșuează, suspectați o problemă la nivelul planului de control, al programării, al capacității sau al furnizării. Dacă conectivitatea IP funcționează, dar numele serviciilor eșuează, investigați DNS-ul. Dacă ratele de eroare cresc după un anunț de recuperare, căutați furtuni de reîncercări, restanțe, contracte de închiriere expirate, bucle de feedback pentru verificarea stării de funcționare sau capacitate de recuperare insuficientă.
Sistemele de stare a furnizorilor pot ajuta, de asemenea, la distingerea unui incident de platformă de o eroare specifică aplicației. Google Cloud, de exemplu, publică incidentele actuale și istorice prin intermediul tabloului de bord oficial Service Health , în timp ce AWS publică rezumate ale evenimentelor majore prin intermediul rezumatelor oficiale post-eveniment .
Ce pot face clienții pentru a reduce impactul
Nicio arhitectură nu poate garanta zero întreruperi, dar mai multe opțiuni de design reduc expunerea. Folosiți mai multe zone de disponibilitate pentru sarcinile de lucru de producție atunci când serviciul le acceptă. Pentru sarcinile de lucru care nu pot tolera o întrerupere regională, evaluați designurile multi-regiune și înțelegeți compromisurile în ceea ce privește consistența datelor. Eliminați punctele unice de eroare ascunse, cum ar fi un serviciu de identitate regional, o cale DNS sau un API administrativ de care depinde fiecare acțiune de recuperare.
Aplicațiile ar trebui, de asemenea, să eșueze fără probleme. Aceasta poate însemna servirea conținutului din cache, plasarea în coadă a scrierilor necritice, limitarea reîncercărilor cu backoff și jitter exponențiale, separarea operațiunilor din planul de control de traficul din planul de date și păstrarea unui mod redus de „doar citire” sau „tranzacție de bază” în timpul întreruperilor parțiale. Procedurile de recuperare ar trebui testate în condiții de întârziere, deoarece repornirea unei dependențe într-un mediu de testare gol este foarte diferită de restaurarea uneia în timp ce milioane de cereri sunt în așteptare.
Lecția cheie din nefuncționarea pe scară largă a cloud-ului
Revenim la scenariul Northstar Cloud. Schimbarea configurației de la 10:05 poate fi declanșatorul, dar nu este întreaga explicație. Întreruperea se extinde deoarece rețeaua este partajată, automatizarea conține un defect de sincronizare, serviciile din aval depind de aceeași stare, verificările de sănătate elimină capacitatea, reîncercările cresc sarcina, iar sistemele de recuperare trebuie să proceseze o acumulare uriașă de resurse.
Acesta este modelul central din spatele multor incidente majore în cloud: defecțiunea inițiată este adesea mică în comparație cu lanțul de dependențe care o amplifică. Prin urmare, înțelegerea timpului de nefuncționare a cloud-ului înseamnă examinarea atât a cauzei principale, cât și a propagării. Cele mai rezistente proiecte presupun că componentele individuale vor eșua și se concentrează pe prevenirea declanșării unor defecțiuni la nivelul întregului sistem.