Acasă
» Tehnologie
»
Semiconductori de generație următoare: Cum inteligența artificială și supercomputerele depășesc limitele tranzistoarelor mai mici
Semiconductori de generație următoare: Cum inteligența artificială și supercomputerele depășesc limitele tranzistoarelor mai mici
Răspunsul scurt: Câștigurile inteligenței artificiale provin acum din întregul sistem de semiconductori
Următoarea generație de hardware pentru inteligența artificială și supercomputer nu este alimentată de o singură descoperire. Este construită din mai multe tehnologii care trebuie să funcționeze împreună: tranzistoare gate-all-around, alimentare backside, arhitecturi chiplet, împachetări avansate, memorie cu lățime de bandă mare, legături die-to-die mai rapide și o creștere a interfețelor optice. Rezultatul practic este mai multă putere de calcul, mai multă lățime de bandă a memoriei și o scalare mai bună, fără a se baza doar pe dimensiuni mai mici ale tranzistoarelor.
Acest lucru contează deoarece acceleratoarele moderne de inteligență artificială și supercomputerele științifice se confruntă adesea cu limite de transfer de date și de putere înainte de a epuiza capacitatea aritmetică brută. Un motor matricial mai rapid ajută doar dacă ponderile modelului, activările și rezultatele intermediare îl pot atinge suficient de repede. În mod similar, adăugarea mai multor acceleratoare ajută doar dacă pachetul, rețeaua de rack-uri, sistemul de memorie, sistemul de răcire și stiva de software le pot menține ocupate.
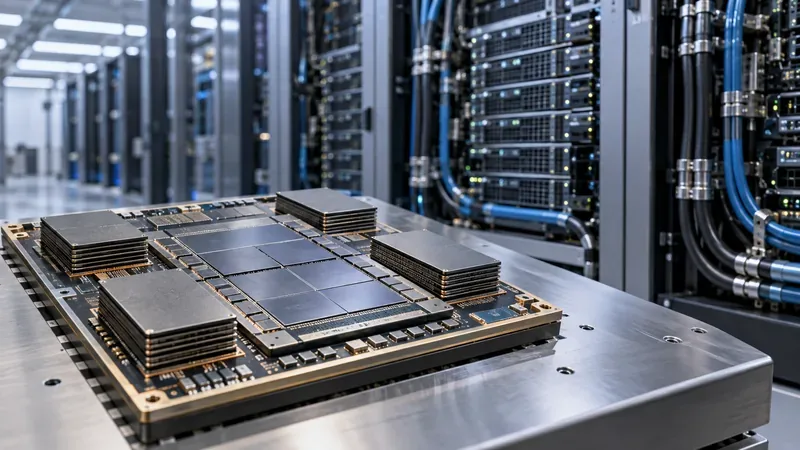
Un modul accelerator multi-cip cu mai multe pachete de memorie suprapuse ilustrează direcția hardware-ului modern de inteligență artificială: calculul, memoria, împachetarea, furnizarea de energie și răcirea sunt proiectate din ce în ce mai mult ca un singur sistem.
1. Noile structuri ale tranzistoarelor îmbunătățesc eficiența, dar reprezintă doar punctul de plecare
Logica de vârf depășește structura FinFET care a dominat cipurile avansate ani de zile. Design-urile de tip „gate-all-around” sau GAA înfășoară poarta în jurul unei nano-folii sau a unei structuri de canal similare, oferind proiectanților de cipuri un control electrostatic mai strict pe măsură ce caracteristicile se micșorează. Acest lucru poate îmbunătăți performanța, reduce scurgerile sau oferă un echilibru mai bun între cele două.
TSMC afirmă că procesul său N2 de 2 nanometri a intrat în producția de volum în al patrulea trimestru al anului 2025, în timp ce tehnologia sa A16 combină tranzistoare nano-pliuri cu o linie de alimentare din spate, destinată în special produselor de calcul de înaltă performanță cu nevoi dense de furnizare a energiei. TSMC a declarat că producția de volum a A16 este programată pentru a doua jumătate a anului 2026. Consultați pagina despre tehnologia A16 a turnătoriei și raportul anual pe 2025 .
Intel urmează o direcție similară cu Intel 18A. Procesul său combină tranzistoarele RibbonFET GAA cu alimentarea prin backside PowerVia. Intel raportează că modelul 18A a intrat în producție în 2025, în timp ce versiunea îmbunătățită 18A-P a intrat în producție cu risc în iunie 2026. Intel publică, de asemenea, informații comparative privind performanța, puterea și densitatea nodului; aceste cifre sunt raportate de furnizor și ar trebui validate în raport cu un design specific, mai degrabă decât tratate ca câștiguri universale la nivel de cip. Detaliile actuale se găsesc pe pagina Intel dedicată procesului 18A .
Alimentarea cu energie electrică din spate este importantă deoarece cipurile avansate trebuie să direcționeze atât semnalele, cât și energia electrică prin cabluri extrem de dense. Mutarea unei părți din rețeaua de alimentare cu energie electrică în spate poate elibera resurse de rutare pe partea semnalului și poate îmbunătăți furnizarea tensiunii. Pentru acceleratoarele de inteligență artificială, unde rețele mari de unități de calcul comută la rate mari, acest lucru poate fi la fel de important ca densitatea tranzistoarelor.
2. Chipleturile și ambalajele avansate transformă un pachet într-un sistem de calcul de mici dimensiuni
Pe măsură ce cresc, matrițele monolitice devin mai greu și mai scumpe de scalat. Chipleturile oferă o altă cale: funcții separate pot fi fabricate pe tehnologii de proces care li se potrivesc cel mai bine, apoi conectate într-un singur pachet. O matriță de calcul poate necesita cel mai avansat proces logic, în timp ce I/O, memoria cache, circuitele analogice sau alte funcții pot să nu aibă nevoie.
Împachetarea este ceea ce face ca acest lucru să fie practic. Platforma avansată de packaging CoWoS de la TSMC , de exemplu, este concepută pentru a integra mai multe dispozitive logice și stive de memorie cu lățime de bandă mare într-o capsulare 2.5D. TSMC poziționează CoWoS în mod specific pentru produsele AI și HPC, unde conexiunile scurte și largi dintre calcul și HBM sunt critice.
De asemenea, apar standarde pentru a face chipleturile mai puțin proprietare. Specificația UCIe 3.0 , lansată în august 2025, acceptă rate de transfer de date de 48 GT/s și 64 GT/s și adaugă caracteristici pentru eficiență energetică, gestionabilitate și sisteme multi-cip mai flexibile. UCIe nu face chipleturile interschimbabile peste noapte, dar oferă industriei un cadru electric și de protocol comun pentru legăturile integrate în pachet.
Această abordare este deosebit de atractivă atunci când o companie dorește să construiască mai multe variante de acceleratoare din blocuri de construcție reutilizabile. Este mai puțin atractivă atunci când costul pachetului, densitatea termică sau complexitatea designului depășesc beneficiul modularității. Un produs mai mic, cu nevoi modeste de memorie și I/O, poate fi totuși mai bine deservit de un dispozitiv monolitic mai simplu.
3. Memoria cu lățime de bandă mare devine la fel de strategică ca acceleratorul în sine
Sarcinile de lucru bazate pe inteligență artificială mută în mod repetat tensori mari între memorie și unități de calcul. Acest lucru face ca lățimea de bandă a memoriei să fie o constrângere de proiectare de ordinul întâi. Memoria cu lățime de bandă mare, sau HBM, abordează problema prin stivuirea matrițelor DRAM și plasarea lor fizic aproape de accelerator printr-o interfață foarte lată.
HBM4 trece acum de la limbajul de tip „roadmap” la sistemele comerciale. Samsung a anunțat livrări comerciale de HBM4 în februarie 2026 și a declarat că produsul său a intrat în producția de masă cu o rată de transfer susținută de 11,7 Gb/s, cu o capacitate de până la 13 Gb/s. În mai 2026, Samsung a anunțat, de asemenea, livrarea de mostre HBM4E. Aceste detalii sunt disponibile în anunțul Samsung privind producția de HBM4 .
În rezultatele sale din al doilea trimestru al anului 2026, SK Hynix a anunțat că a început livrările în masă de HBM4 în cursul trimestrului și că intenționează să intensifice producția în a doua jumătate a anului. Compania a livrat, de asemenea, mostre de HBM4E cu 12 straturi. Consultați rezultatele SK Hynix din trimestrul 2 al anului 2026 pentru starea actuală.
De ce contează acest lucru în practică? Specificațiile actuale Vera Rubin de la NVIDIA listează 288 GB de HBM4 pe un GPU Rubin și 19,2 TB/s de lățime de bandă a memoriei GPU. Prin comparație, acceleratoarele din seria MI350 de la AMD utilizează HBM3E; AMD listează până la 288 GB și 8 TB/s pentru MI355X. Acestea sunt arhitecturi diferite și nu ar trebui comparate doar pe baza unei cifre de lățime de bandă, dar ambele ilustrează modul în care capacitatea memoriei și lățimea de bandă sunt acum specificații de bază ale acceleratorului, mai degrabă decât detalii secundare. Consultați specificațiile oficiale NVIDIA Vera Rubin NVL72 și pagina AMD Instinct MI350 Series .
4. Interconexiunile de tip scaling-up și scaling-out determină dacă mai multe acceleratoare acționează ca unul singur
Modelele mari și simulările științifice rareori se potrivesc perfect pe un singur dispozitiv. Sistemul trebuie să împartă munca între mai multe acceleratoare și să facă schimb frecvent de rezultate parțiale. Dacă comunicarea este lentă, unitățile de calcul scumpe stau inactive.
De aceea, structurile structurale proprietare de tip scale-up avansează alături de GPU-urile în sine. Platforma Rubin de la NVIDIA utilizează NVLink de a șasea generație; NVIDIA listează o lățime de bandă NVLink de 3 TB/s per GPU Rubin și 216 TB/s pe un sistem NVL72. AMD utilizează Infinity Fabric pe platformele sale de accelerare. Pentru cumpărători, întrebarea importantă nu este doar lățimea de bandă maximă a legăturii, ci și modul în care se comportă structura structurală în funcție de operațiunile colective exacte, modelele paralele cu modelul și topologia utilizate de aplicație.
La nivel de memorie de sistem, Compute Express Link este, de asemenea, în continuă evoluție. Consorțiul CXL afirmă că CXL 4.0 dublează viteza de semnalizare de la 64 GT/s la 128 GT/s, adaugă porturi incluse și extinde funcțiile de fiabilitate a memoriei. CXL este relevant atunci când arhitecții doresc o extindere coerentă a memoriei, pooling sau dezagregare fără a trata fiecare nivel de memorie ca un dispozitiv de stocare la distanță.
5. Fotonica pe siliciu se apropie de siliciul de comutare
Cuprul rămâne excelent pentru conexiuni electrice scurte și dense, dar legăturile optice devin din ce în ce mai atractive pe măsură ce distanța și lățimea de bandă agregată cresc. Un pas important următor este optica co-ambalată, în care componentele optice sunt mutate mai aproape de ASIC-ul de rețea în loc să se afle în întregime în transceivere conectabile la marginea unui comutator.
NVIDIA afirmă că platforma sa Spectrum-X Ethernet Photonics utilizează optică integrată și raportează o eficiență energetică a rețelei de până la 5 ori mai bună decât modelele tradiționale de transceivere conectabile. Aceasta este o comparație între furnizori, nu o garanție pentru fiecare topologie de centru de date, dar evidențiază direcția în care se află lucrurile: alimentarea rețelei devine suficient de importantă încât integrarea optică face acum parte din proiectarea sistemelor semiconductoare. Consultați prezentarea generală a fotonicii pe siliciu de la NVIDIA .
Ce înseamnă acest lucru pentru sarcinile de lucru reale legate de inteligența artificială și supercomputer
Sarcină de lucru
Caracteristicile semiconductorilor de prioritizat
De ce contează
Pre-antrenament pentru modele mari
Capacitate și lățime de bandă HBM, legături rapide de scalare, carcase dense, răcire puternică
Antrenamentul constă în mare măsură în mișcarea tensorală și comunicarea sincronizată între mai multe acceleratoare.
Inferență agentială și contextuală lungă
Pool-uri HBM mari, calcul eficient cu precizie redusă, lățime de bandă mare de interconectare, suprapunere de memorie pe niveluri
Cache-ul KV și pașii de raționament repetați pot face ca capacitatea memoriei și mișcarea datelor să fie mai limitative decât numărul maxim de FLOPS-uri.
HPC științific
Capacitate FP64, lățime de bandă a memoriei, interconexiuni fiabile, biblioteci numerice mature
Codurile de simulare depind adesea de precizie dublă și lățime de bandă susținută, mai degrabă decât doar de randament tensorial de precizie scăzută.
Inferență la nivel de întreprindere
Performanță per watt, compatibilitate software, memorie de dimensiuni potrivite, opțiuni de implementare PCIe
Cel mai bun sistem ar putea fi unul care se potrivește serverelor și anvelopelor de alimentare existente, mai degrabă decât arhitectura rack cu cea mai mare densitate.
Acceleratoare personalizate
Strategie pentru chipleți, ecosistem de ambalaje, suport UCIe, maturitate a procesului
Modularitatea poate scurta ciclurile de reutilizare, dar complexitatea ambalajelor și calificarea lanțului de aprovizionare pot compensa beneficiul.
Un exemplu concret: de ce un GPU mai rapid nu este suficient
Să luăm în considerare o echipă care deservește un model lingvistic extins, cu ferestre de context lungi. Să presupunem că profilarea arată că GPU-urile așteaptă frecvent transferuri de memorie și comunicare între GPU-uri. Trecerea la un accelerator mai nou ar putea ajuta, dar numai dacă noul sistem oferă și suficientă capacitate HBM, o lățime de bandă a memoriei mai rapidă și o topologie care reduce blocajele de comunicare. Achiziționarea unui dispozitiv cu performanțe tensoriale teoretice mai bune, păstrând în același timp aceleași blocaje de memorie și de rețea, ar putea oferi o îmbunătățire mult mai mică decât sugerează specificația principală.
Același principiu apare și în supercalculul tradițional. Sistemul Frontier al Laboratorului Național Oak Ridge combină acceleratoarele AMD MI250X cu HBM și o interconectare de sistem de mare viteză. Ghidul utilizatorului Frontier documentează modul în care funcționează împreună calculul, HBM, legăturile CPU-GPU și rețeaua Slingshot. Generația hardware este mai veche decât cele mai noi platforme de inteligență artificială din 2026, dar lecția arhitecturală este încă actuală: performanța susținută a aplicațiilor depinde de calea dintre calcul, memorie și alte noduri.
Când merită modernizarea hardware-ului semiconductor de generație următoare?
O modernizare este cea mai justificabilă atunci când rezolvă o problemă semnificativă, în loc să înlocuiască pur și simplu o piesă mai veche. Înainte de a vă angaja într-o nouă generație de acceleratoare, verificați următoarele:
Presiune asupra memoriei: Modelul sau simularea se revarsă în memoria gazdă, necesită puncte de control agresive sau forțează un grad incomod de partiționare a modelului?
Presiune asupra lățimii de bandă: Nucleele sunt limitate de memorie în profilare sau acceleratoarele petrec un timp semnificativ așteptând operațiunile all-reduce și alte operațiuni colective?
Alimentare și răcire: Pot rack-ul, instalația și bucla de răcire să suporte noua densitate de putere? Performanța mai mare poate fi totuși o opțiune nepotrivită dacă modernizările infrastructurii domină costurile.
Pregătire software: Sunt compilatorul, bibliotecile, nucleele, stiva de orchestrare și instrumentele de monitorizare mature pentru noua arhitectură?
Cerințe de precizie: Poate sarcina de lucru să utilizeze în siguranță formate cu precizie mai mică sau necesită FP64 sau o altă cale de precizie mai mare?
Utilizare: Va menține volumul de lucru noul hardware suficient de solicitat pentru a-i justifica costul? Capacitatea inactivă nu devine economică deoarece cipul este mai nou.
Compromisurile devin mai fizice
Progresul în domeniul semiconductorilor produce capacități impresionante, dar factorii limitatori sunt din ce în ce mai tangibili. Carcasele avansate sunt mai mari și mai dificil de fabricat. Stivele HBM concentrează căldura în apropierea logicii de mare putere. Sistemele la scară rack pot necesita răcire cu lichid, distribuție densă a energiei și rețele specializate. Optica co-ambalată poate reduce puterea de rețea, dar introduce noi considerații de fabricație și service. Chipleturile pot îmbunătăți modularitatea, dar adaugă validare, împachetare și gestionare a randamentului.
Există, de asemenea, un compromis software. Aritmetica de precizie scăzută, cum ar fi FP8, FP6 sau FP4, poate crește considerabil randamentul inteligenței artificiale, dar software-ul trebuie să păstreze calitatea modelului. Codurile științifice pot să nu poată utiliza aceleași scurtături. O caracteristică a semiconductorilor este valoroasă numai atunci când stiva de aplicații o poate exploata fără a încălca cerințele de precizie sau fiabilitate.
Ce să urmărești în continuare
Pentru restul anului 2026 și începutul anului 2027, cele mai utile semnale nu sunt doar numele noilor noduri. Urmăriți dacă procesele A16 de la TSMC și familia 18A de la Intel se integrează în produse pentru clienții largi; cât de repede HBM4 și HBM4E devin disponibile la scară largă; dacă UCIe 3.0 creează o interoperabilitate semnificativă a chipletelor multi-vendor; unde apare CXL 4.0 în sistemele de producție; și dacă optica co-ambalată se dovedește economică și funcțională la scară largă.
Aceste etape importante vor arăta dacă industria semiconductorilor poate continua să extindă inteligența artificială și supercomputerele fără a permite ca mișcarea memoriei, furnizarea de energie, crearea de rețele și răcirea să consume câștigurile obținute de logica mai densă.
Concluzie
Viitorul inteligenței artificiale și al supercomputerelor este alimentat mai puțin de un singur „nod următor” și mai mult de ingineria coordonată a semiconductorilor. Tranzistoarele GAA și alimentarea backside îmbunătățesc fundația logică. Chipleturile și ambalajele avansate permit proiectanților să asambleze sisteme mai mari decât poate oferi confortabil un singur die. HBM4 alimentează acceleratoarele la lățime de bandă extremă. UCIe, CXL, NVLink, Infinity Fabric și rețelele optice mută datele pe domenii progresiv mai mari.
Dacă alegeți hardware, începeți cu blocajul real al sarcinii de lucru. Pentru inteligența artificială limitată la memorie, acordați prioritate capacității și lățimii de bandă HBM. Pentru antrenamentul distribuit, acordați prioritate structurii de scalare verticală și orizontală. Pentru calculul științific, verificați performanța FP64 și a bibliotecii. Pentru implementarea la nivel de întreprindere, includeți în decizie alimentarea, răcirea, suportul software și efortul de integrare. Cel mai rapid semiconductor pe hârtie nu este automat cel mai rapid sau cel mai economic sistem pentru sarcina de lucru.