Reduceți presiunea memoriei PostgreSQL în sinapsa matriceală
Află dacă memoria PostgreSQL provine din interogări, buffere partajate, conexiuni sau mentenanță, apoi fă modificări specifice, sigure pentru sinapse.
Începeți prin a verifica dacă joncțiunile lente afectează o singură cameră, un server de acasă la distanță sau fiecare cameră federată. Folosiți starea destinației de federație și jurnalele Synapse pentru a localiza erori repetate înainte de a modifica timeout-urile sau de a adăuga workeri. O joncțiune traversează limitele serverului de acasă și schimbă date despre autorizarea joncțiunii și starea camerei, astfel încât un server de la distanță lent sau o cameră mare poate întârzia o joncțiune chiar și atunci când propriul server este funcțional.
Specificația server-server Matrix descrie handshake-ul make_joinși send_joinstarea returnată unui server care se conectează. Aceasta înseamnă că „lag-ul de federație” nu este automat o problemă locală a cozii Synapse. Verificările de mai jos disting cauzele probabile.
Comparați o joncțiune lentă cu o joncțiune către o altă cameră federată. Întrebați dacă alți utilizatori de pe serverul dvs. de acasă raportează aceeași întârziere și notați ID-ul sau aliasul camerei și numele serverelor la distanță implicate. Dacă o singură cameră este lentă, starea camerei sau serverele de acasă deja existente în ea ar putea fi cauza. Dacă multe camere care implică același server la distanță sunt lente, verificați accesibilitatea și starea de reîncercare a destinației respective. Dacă joncțiunile către mai multe servere fără legătură sunt lente, investigați propriile resurse și calea de federație de ieșire.
Pentru serverul la distanță afectat, interogați API-ul Federation Admin al Synapse de pe mașina care rulează Synapse:
curl -H "Authorization: Bearer $SYNAPSE_ADMIN_TOKEN" \
  "http://127.0.0.1:8008/_synapse/admin/v1/federation/destinations/remote.example"
Înlocuiți remote.examplecu numele serverului de domiciliu și utilizați adresa client-listener pentru implementarea dvs. O valoare diferită de zero retry_last_tsși una pozitivă retry_intervalindică faptul că Synapse a înregistrat recent o conexiune eșuată și așteaptă înainte de a reîncerca. Verificați jurnalele Synapse corespunzătoare pentru eroarea reală, cum ar fi erori DNS, TLS, de conexiune sau de răspuns la distanță. Synapse documentează acest API de administrare a federației ca fiind experimental și supus modificărilor; consultați documentația pentru versiunea pe care o executați. Păstrați API-ul de administrare privat și nu lipiți token-ul său de acces într-o solicitare publică de asistență.
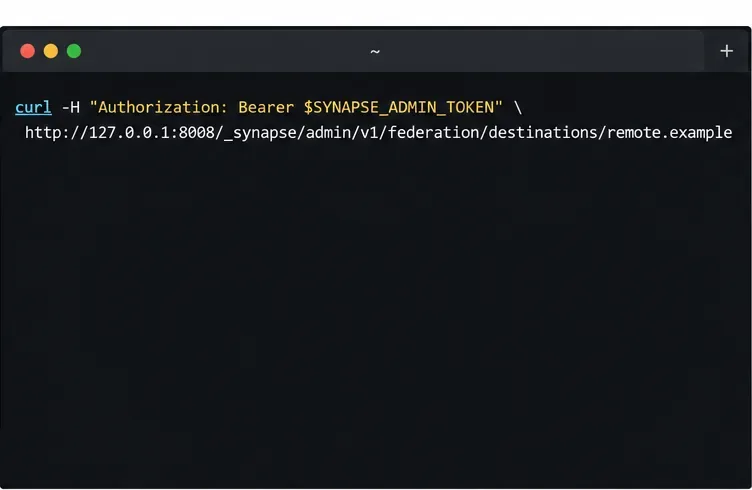
Ilustrație a unei solicitări locale, autentificate, privind starea destinației. Panoul afișează doar o comandă, nu un răspuns live.
Dacă suspectați că alte servere nu pot ajunge la propriul server de domiciliu, rulați Matrix Federation Tester oficial pentru numele serverului dvs. Acesta verifică descoperirea și conectivitatea federației publice. Nu dovedește în sine că o solicitare de ieșire de la gazda dvs. Synapse către un anumit peer are succes, așa că comparați raportul său cu propriile jurnalele și starea destinației.
Dacă Prometheus preia deja datele din endpoint-ul dvs. de metrici Synapse, adăugați domeniile afectate la federation_metrics_domains, homeserver.yamlapoi reîncărcați sau reporniți Synapse în funcție de procesul de implementare. Synapse poate expune metricile Prometheus pentru vârsta evenimentelor persistente de cameră (PDU) trimise către și primite de la domeniile pe care le listați, așa cum este descris în manualul de configurare :
federation_metrics_domains:
  - matrix.org
  - remote.example
Folosește seria temporală rezultată pentru a vedea dacă vârsta evenimentelor de ieșire sau de intrare crește. Tratamentează-l ca pe un indiciu direcțional, nu ca pe un verdict: documentația de configurare Synapse avertizează că întârzierea poate proveni fie de la serverul principal, fie de la rețeaua dintre ele. O serie de ieșire cu întârziere pe mai multe destinații indică calea de trimitere sau capacitatea locală; o întârziere izolată la un singur peer solicită verificarea acelui peer și a rutei către acesta.
Ilustrarea conceptului de diagramă a vârstei federației; liniile nu reprezintă măsurători în timp real de la un server Synapse.

Ilustrație a setării Synapse utilizată pentru a activa metricile de vârstă PDU pentru domeniile la distanță selectate.
Dacă multe operațiuni sunt lente, verificați și procesorul, memoria, latența bazei de date și tabloul de bord Synapse pentru durata tranzacțiilor. Ghidul Grafana de la Synapse menționează că persist_eventsscrie evenimente în baza de date și poate avea o durată mare a tranzacțiilor; de asemenea, explică faptul că multe extremități directe pot crește munca de rezoluție a stării. Dacă aceste măsurători locale sunt ridicate în același timp cu joncțiunile, remediați blocajul resursei sau al bazei de date înainte de a regla reîncercările de federație.
Adăugați capacitatea expeditorului numai atunci când monitorizarea arată că se face backup la activitățile de ieșire în mai multe destinații, iar procesul curent este restricționat. Documentația actuală a lucrătorului Synapse recomandă utilizarea synapse.app.generic_worker`with` federation_sender_instancespentru acest rol, în loc să creați noi implementări în jurul tipului de lucrător dedicat expeditorului, mai vechi.
Fiecare destinație de ieșire este atribuită unui expeditor pe baza unui hash al numelui serverului la distanță. Mai mulți lucrători de expeditori pot distribui traficul pe mai multe servere la distanță, dar solicitările către o destinație lentă se mapează în continuare la un singur lucrător. Prin urmare, adăugarea de lucrători este puțin probabil să rezolve o problemă cu un singur peer. Numele lucrătorilor din configurația partajată trebuie să corespundă cu lucrătorii care rulează; atunci când modificați lista de instanțe de expeditor, opriți și porniți toți expeditorii de federație împreună, astfel încât să utilizeze aceeași configurație.
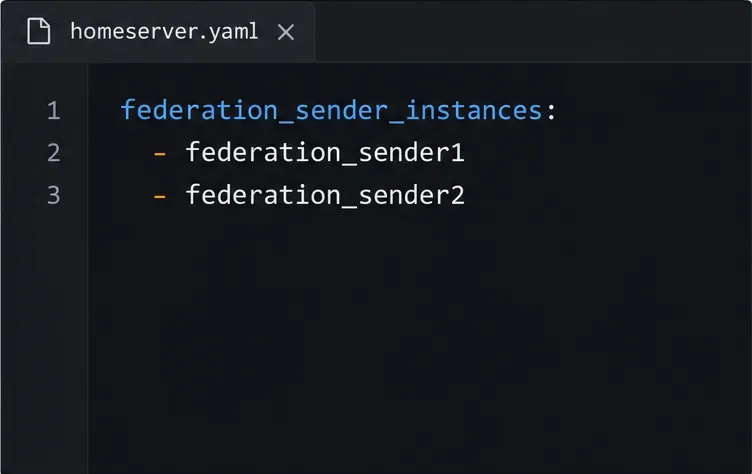
Ilustrație a listei federation_sender_instances; fiecare lucrător numit trebuie să existe în implementare.
Resetați cronometrul de reîncercare al unei destinații numai după corectarea unei probleme de conectivitate tranzitorie și confirmarea faptului că Synapse a marcat destinația respectivă ca eșuată. API-ul Admin oferă un POST /_synapse/admin/v1/federation/destinations/<destination>/reset_connectionpunct final; solicitarea sa rulează în fundal, deci un HTTP 200 imediat nu înseamnă că federația a revenit. Acest punct final este, de asemenea, documentat ca fiind experimental.
Nu generați federation.client_timeoutca prim răspuns. Manualul de configurare actual îi atribuie o valoare implicită de 60 de secunde. Un timeout mai lung oferă unui server la distanță lent mai mult timp pentru a răspunde; nu face serverul sau rețeaua mai rapidă și poate lăsa cererile de alăturare în așteptare mai mult timp. Modificați-l numai atunci când jurnalele arată că cererile legitime de federație depășesc valoarea curentă și ați verificat capacitatea serverului.
Reîncercați să vă alăturați aceleiași camere și comparați-o cu o altă cameră federată. Confirmați că destinația afectată nu mai afișează un interval de reîncercare în creștere, jurnalele arată solicitări de federare reușite și metricile configurate privind vârsta PDU-ului nu mai cresc. Dacă o singură cameră rămâne lentă, în timp ce alte destinații sunt sănătoase, partajați ID-ul camerei sale, serverul de acasă la distanță implicat, fereastra de timp și liniile de eroare redactate cu administratorii camerei sau cu asistența Synapse. Evitați trimiterea de token-uri de acces sau anteturi de autorizare completă.
Află dacă memoria PostgreSQL provine din interogări, buffere partajate, conexiuni sau mentenanță, apoi fă modificări specifice, sigure pentru sinapse.
Urmăriți alăturările lente ale camerei Matrix la un server de acasă la distanță, retragerea temporară a federației, încărcarea bazei de date locale sau o coadă de expediere înainte de a modifica setările Synapse.
Opriți crearea de conturi deschise pe un server Synapse auto-găzduit sau mențineți înscrierile doar pe bază de invitație cu token-uri de înregistrare cu utilizare limitată.
Ștergeți avertismentul Element privind sesiunea neverificată folosind un dispozitiv sau o cheie de recuperare de încredere, cu verificări care vă protejează istoricul criptat al chatului.
Distingeți conflictul de blocare a bazei de date de blocările WebDAV expirate, apoi alegeți și configurați remedierea corectă pentru ownCloud 10.
Urmăriți un ecran web ownCloud gol până la memoria cache a browserului, resursele web lipsă, erorile de serviciu sau setările URL de proxy invers cu verificări direcționate.
Setați limita de memorie web PHP a ownCloud, reporniți serviciul de potrivire și verificați valoarea activă fără a o confunda cu setările CLI sau limitele de încărcare.
Află dacă MySQL, PHP, setările socketului sau permisiunile bazei de date blochează ownCloud 10, apoi verifică o soluție sigură.
Faceți obligatorie expirarea linkurilor publice în ownCloud Classic, setați o durată maximă de viață și verificați partajările existente care ar putea necesita curățare separată.
Activați TOTP prin Keycloak, înscrieți utilizatorii în siguranță și înțelegeți când se aplică setările MFA la nivel de rută ale Infinite Scale.


